22 年初建博客伊始,便于前端领域门前久久徘徊
磕磕绊绊运行半年有余,渐觉有所不逮
至此开始系统性学习,笔记皆誊录于此,以兹备忘
Html
语义化标签
- 对开发者友好,让人更容易读懂,利于代码可读性
- 对机器友好,让搜索引擎更容易读懂,利于seo
b/strong、i/em
- strong 是有语义的,起到加强语气的效果,遇到阅读器会重读,即为了强调而加粗
- em 起到强调文本的作用
src 与 href 的区别
- href 标识超文本引用,用在 link 和 a 等元素上,href 是引用和页面关联,是在当前元素和引用资源之间建立联系
- src 表示引用资源,表示替换当前元素,用在 img,script,iframe 上,src是页面内容不可缺少的一部分。
script 标签中 defer 和 async 的区别
- 多个带 defer 的 script 标签里 js 同步执行,async 是异步执行
- async script: 解析 HTML 过程中进行脚本的异步下载,下载成功立马执行,有可能会阻断 HTML 的解析。
- defer script: 完全不会阻碍 HTML 的解析,等所有元素解析完成之后,DOMContentLoaded 之前执行再 script。
CSS
盒子模型
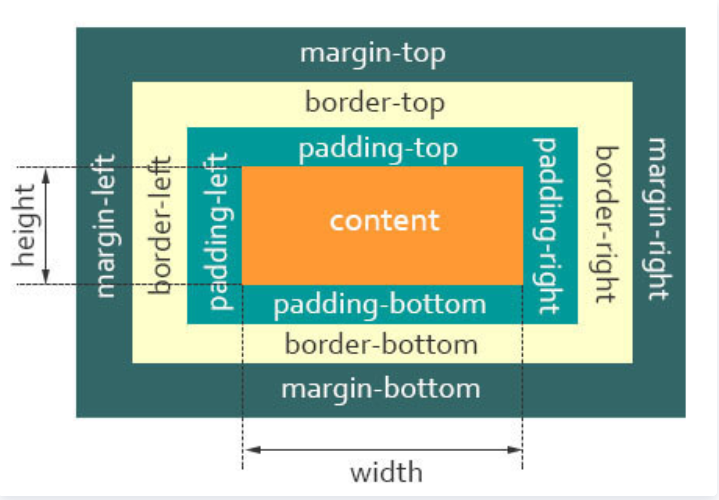
content - padding - border - margin
- W3C 标准盒子模型(
width/height只包含content值, Box-sizing: content-box) - IE 怪异盒子模型(
width/height包含了padding和border值, Box-sizing: border-box)
选择器相关
选择器
标签、类、ID、属性、后代、子代、通用*、伪类 a:visited、伪元素 p::after
- a:nth-child(4) 好理解,直接数个数
- a:nth-of-type(4) 先对 tag 标签分组,再选择每组标签的第四个元素
- 属性选择器
- [attribute=value] 选择所有使用attribute=value的元素
- [attribute^=value]:选择attribute属性开头为value的所有元素
- [attribute*=value] 选择attribute属性包含value的元素
优先级
内联样式 > ID选择器 > 类选择器 > 标签选择器
!important 可以覆盖 内联样式
可继承属性
父元素设置一些属性,后代元素会自动拥有这些属性
[字体、文本、可见性、列表、引用]
- 字体属性 font-
- 文本属性:颜色、缩进、行高
- 元素可见性 visibility
- 表格布局属性 table-layout
- 列表样式 list-style
- 引用 quotes
- 光标属性 cursor
不能继承
- a 标签的字体颜色不能被继承
- h1-h6标签字体的大小也是不能被继承的
- display
- 文本属性:vertical-align、text-decoration
- 盒子模型的属性:宽度、高度、内外边距、边框等
- 定位属性:浮动、清除浮动、定位position等
CSS 单位
| 相对长度单位 | em、ex、ch、rem、vw、vh、vmin、vmax、% |
|---|---|
| 绝对长度单位 | cm、mm、in、px、pt、pc |
- 这里主要讲述px、em、rem、vh、vw
- px,表示像素,所谓像素就是呈现在我们显示器上的一个个小点,每个像素点都是大小等同的,所以像素为计量单位被分在了绝对长度单位中
- em 是相对长度单位。相对于当前对象内文本的字体尺寸。如当前对行内文本的字体尺寸未被人为设置,则相对于浏览器的默认字体尺寸(
1em = 16px)- em 会继承父级元素的字体大小
- rem,相对单位,相对的只是HTML根元素
font-size的值 - vw ,就是根据窗口的宽度
- 像
vw、vh,比较容易混淆的一个单位是%,不过百分比宽泛的讲是相对于父元素
设备像素,DPR
dpr(device pixel ratio),设备像素比,代表设备独立像素到设备像素的转换关系,在JavaScript中可以通过 window.devicePixelRatio 获取
1 个虚拟像素被换算成几个物理像素,这个数值我们称之为设备像素比
- 当设备像素比为1:1时,使用1(1×1)个设备像素显示1个CSS像素
- 当设备像素比为2:1时,使用4(2×2)个设备像素显示1个CSS像素
- 当设备像素比为3:1时,使用9(3×3)个设备像素显示1个CSS像素
iPhone 3GS 和 iPhone 4/4s 的尺寸都是 3.5 寸,但 iPhone 3GS 的分辨率是 320x480,iPhone 4/4s 的分辨率是 640x960
这意味着,iPhone 3GS 有 320 个物理像素,iPhone 4/4s 有 640 个物理像素
如果我们按照真实的物理像素进行布局,比如说我们按照 320 物理像素进行布局,到了 640 物理像素的手机上就会有一半的空白,为了避免这种问题,就产生了虚拟像素单位
我们统一 iPhone 3GS 和 iPhone 4/4s 都是 320 个虚拟像素,只是在 iPhone 3GS 上,最终 1 个虚拟像素换算成 1 个物理像素,在 iphone 4s 中,1 个虚拟像素最终换算成 2 个物理像素
清除浮动
当内部元素被设置为浮动时,父元素高度塌陷的问题
- overflow: hidden; (使其成为 BFC)
- 伪元素(使其成为 BFC)
- .clearfix::after {
- content: “”;
- display: table;
- clear: both;
- }
- .clearfix::after {
- clear:both; (会清除左右两侧的浮动)
隐藏元素 ⭐
- display:none 不占空间,触发重排重绘,自身事件不触发,也不会有过渡效果
- visibility:hidden 隐藏该元素,DOM 存在占空间,自身的事件不会触发,屏幕阅读器看不到
- opacity:0 改变元素透明度,元素不可见,占据页面空间,可以响应点击事件
- 设置 height、width 模型属性为0:不可见,不占据页面空间,无法响应点击事件
- position:absolute 移出可视区域,不可见,不影响页面布局
- clip-path 通过裁剪的形式 polygon(0px 0px,0px 0px,0px 0px,0px 0px);元素不可见,占据页面空间,无法响应点击事件
BFC
我们在页面布局的时候,经常出现以下情况:
- 这个元素高度怎么没了?
- 这两栏布局怎么没法自适应?
- 这两个元素的间距怎么有点奇怪的样子?
原因是元素之间相互的影响,导致了意料之外的情况,这里就涉及到BFC概念
BFC(Block Formatting Context),即块级格式化上下文,它是页面中的一块渲染区域,并且有一套属于自己的渲染规则:
- [margin塌陷] 同一个 BFC 的俩个相邻的盒子的 margin 会发生重叠,与方向无关。
BFC目的是形成一个相对于外界完全独立的空间,让内部的子元素不会影响到外部的元素
- 【盒子浮动时高度塌陷】父元素使用 overflow: hidden; 来保证父元素的高度不会塌陷
- 【浮动塌陷】左盒子 float,右盒子如果不使用 float 就会置于左盒子底部,同样使用 overflow: hidden;
BFC实际就是页面一个独立的容器,里面的子元素不影响外面的元素
水平 + 垂直居中的方法
块级元素
- 子元素绝对定位 + margin: auto
- 子元素绝对定位 + margin: -50%
- 子元素绝对定位 + transform: translate(-50%,-50%);
- table布局
- 设置父元素为
display:table-cell,子元素设置display: inline-block。利用vertical和text-align让所有行内块级元素居中
- 设置父元素为
- flex 布局
- 在父元素中设置以下内容,以控制子元素水平垂直居中
- display: flex时,表示该容器内部的元素将按照flex进行布局
- justify-content: center 主轴方向居中(左右居中)
- align-items: center 交叉轴方向居中(垂直居中)
- grid 布局
- 与 flex 布局同理
- display: grid
- align-items: center
- justify-content: center
上述方法中,不需要知道子元素宽高大小仍能实现水平垂直居中的方法有:
- 利用定位+margin:auto
- 利用定位+transform
- flex布局
- grid布局
内联行内元素
text-align: center
line-height = height
双栏/三栏布局
双栏布局 左边定宽右边自适应
flex 弹性布局
<style> |
flex可以说是最好的方案了,代码少,使用简单
注意的是,flex容器的一个默认属性值:align-items: stretch;
这个属性导致了列等高的效果。 为了让两个盒子高度自动,需要设置: align-items: flex-start
三栏布局
利用flex弹性布局,实现中间自适应
<style type="text/css"> |
实现过程:
- 仅需将容器设置为
display:flex;, - 盒内元素两端对其,将中间元素设置为
100%宽度,或者设为flex:1,即可填充空白 - 盒内元素的高度撑开容器的高度
优点:
- 结构简单直观
- 可以结合 flex的其他功能实现更多效果,例如使用 order属性调整显示顺序,让主体内容优先加载,但展示在中间
也可以使用gird布局模式
<style> |
Flex 弹性盒布局模型
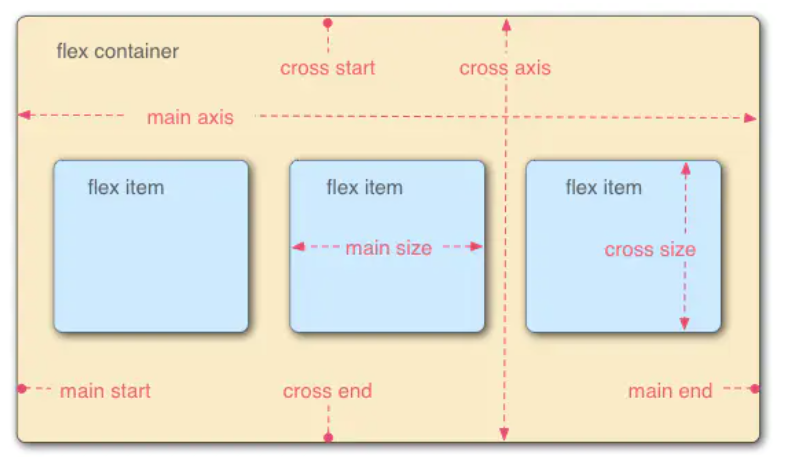
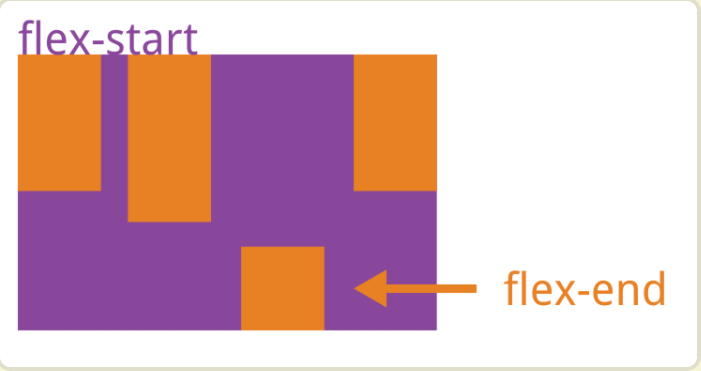
容器中默认存在两条轴,主轴和交叉轴,呈90度关系。项目默认沿主轴排列,通过flex-direction来决定主轴的方向
每根轴都有起点和终点,这对于元素的对齐非常重要
父元素容器属性有:
- flex-direction 主轴排列方向 (row | row-reverse | column | column-reverse)
- flex-wrap 如果主轴排不下,通过
flex-wrap决定容器内项目是否可换行 - flex-flow 是
flex-direction属性和flex-wrap属性的简写形式,默认值为row nowrap - justify-content 项目在主轴上的对齐方式
- center 主轴方向居中(左右居中)
- space-between:两端对齐,项目之间的间隔都相等(左右无空格)
- space-around:两个项目两侧间隔相等(左右有空格)
- align-items 项目在交叉轴上如何对齐
- center 交叉轴方向居中(垂直居中)
- stretch(默认值):如果项目未设置高度或设为auto,将占满整个容器的高度
- align-content 定义了多根轴线的对齐方式。如果项目只有一根轴线,该属性不起作用
- center:与交叉轴的中点对齐
- stretch(默认值):轴线占满整个交叉轴
子元素/容器成员属性有:
order定义项目的排列顺序。数值越小,排列越靠前,默认为 0flex-grow定义项目的放大比例(容器宽度>元素总宽度时如何伸展),默认为0,即如果存在剩余空间,也不放大- 如果所有项目的
flex-grow属性都为1,则它们将等分剩余空间(如果有的话)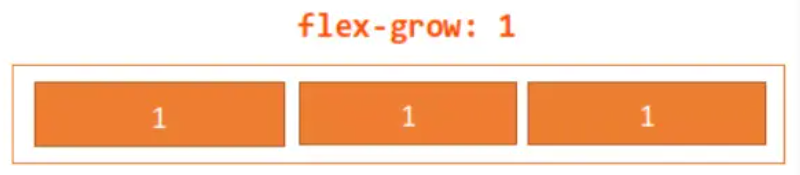
如果一个项目的flex-grow属性为2,其他项目都为1,则前者占据的剩余空间将比其他项多一倍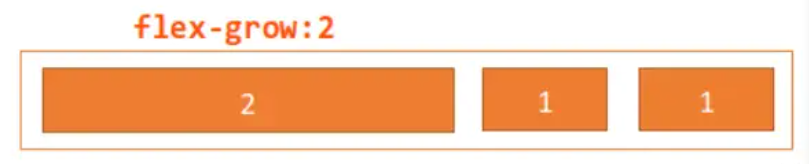
弹性容器的宽度正好等于元素宽度总和,无多余宽度,此时无论flex-grow是什么值都不会生效
- 如果所有项目的
flex-shrink定义了项目的缩小比例(容器宽度<元素总宽度时如何收缩),默认为1,即如果空间不足,该项目将缩小- 如果所有项目的
flex-shrink属性都为1,当空间不足时,都将等比例缩小
如果一个项目的flex-shrink属性为0,其他项目都为1,则空间不足时,前者不缩小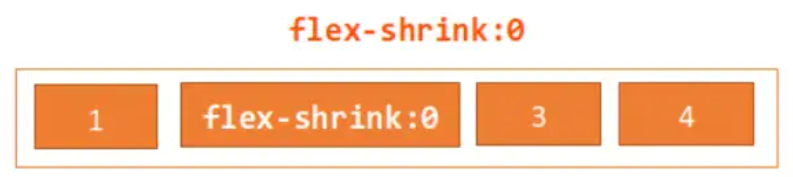
在容器宽度有剩余时,flex-shrink也是不会生效的
- 如果所有项目的
flex-basis设置的是元素在主轴上的初始尺寸,当设置为 0 的是,会根据内容撑开flexflex属性是flex-grow,flex-shrink和flex-basis的简写,默认值为0 1 auto- flex: 1 = flex: 1 1 0%
- flex: 2 = flex: 2 1 0%
- flex: auto = flex: 1 1 auto
- flex: none = flex: 0 0 auto,常用于固定尺寸不伸缩
- 当设置为0时(绝对弹性元素),此时相当于告诉
flex-grow和flex-shrink在伸缩的时候不需要考虑我的尺寸 - 当设置为
auto时(相对弹性元素),此时则需要在伸缩时将元素尺寸纳入考虑 - 注意:建议优先使用这个属性,而不是单独写三个分离的属性,因为浏览器会推算相关值
align-self允许单个项目有与其他项目不一样的对齐方式,可覆盖align-items属性
Grid 布局
二维的布局方式,能够同时处理行与列;与flex一维布局不相同
- display:grid 则该容器是一个块级元素
- display: inline-grid 则容器元素为行内元素
.wrapper { |
- fr:片段单位,为了方便表示比例关系
grid-template-columns: 200px 1fr 2fr 表示第一个列宽设置为 200px,后面剩余的宽度分为两部分,宽度分别为剩余宽度的 1/3 和 2/3
minmax(100px, 1fr)`表示列宽不小于`100px`,不大于`1fr |
grid-auto-flow,默认为row,代表”先行后列”,即先填满第一行,再开始放入第二行
回流(重排)与重绘
- 回流(重排):布局引擎会根据各种样式计算每个盒子在页面上的大小与位置
- 重绘:当计算好盒模型的位置、大小及其他属性后,浏览器根据每个盒子特性进行绘制
具体的浏览器解析渲染机制如下所示: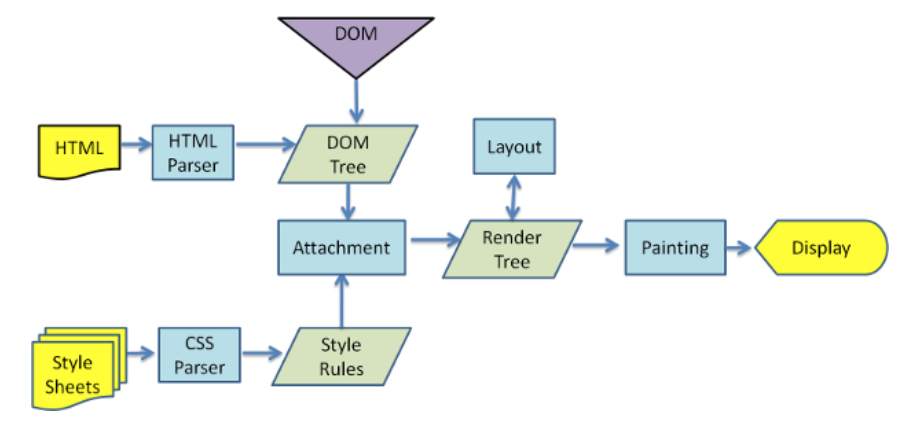
- 解析 HTML,生成DOM树
- 解析 CSS,生成 CSSOM 树(css对象模型树)
- 将 DOM 树和 CSSOM 树结合生成渲染树(Render Tree)
- Layout(回流):根据渲染树,进行回流(Layout),得到节点的位置与大小信息
- Painting(重绘):根据渲染树以及回流得到的几何信息,得到节点的绝对像素进行绘制
- Display:将像素发送给GPU,展示在页面上
回流重排一定会触发重绘
如何减少:
- 将多次修改存储到一个变量中,再对某个元素进行统一修改
- 避免多次修改单一样式,使用类名去合并样式,再对 classList 进行类名操作
- 【离档操作】通过设置元素属性
display: none,将其从页面上去掉,然后再进行后续操作,这些后续操作也不会触发回流与重绘
响应式设计
实现响应式布局的方式有如下:
- 媒体查询
- 百分比
- vw/vh
- rem
- Flex、Grid
- 栅格系统
- 动态改变字体大小
媒体查询
/* 当视口在375px - 600px之间,设置特定字体大小18px */ |
比如给小屏幕手机设置@2x图,为大屏幕手机设置@3x图
百分比布局
子元素的 padding 或 margin 如果设置百分比%,不论是垂直方向或者是水平方向,都相对于直接父元素的 width,而与父元素的 height 无关。
rem
rem是相对于根元素html的font-size属性,默认情况下浏览器字体大小为16px,此时1rem = 16px
可以利用前面提到的媒体查询,针对不同设备分辨率改变font-size的值
除此之外,我们还可以利用主流UI框架,如:element ui、antd提供的栅格布局实现响应式
CSS 优化
异步加载CSS
css 影响 renderTree 的构建,会阻塞页面的渲染,因此应该尽早(将 CSS 放在 head 标签里)和尽快(启用 CDN 实现静态资源加载速度的优化)的将css资源加载
- css加载不会阻塞DOM树的解析
- css加载会阻塞DOM树的渲染(因为 Render Tree 是依赖于DOM Tree 和 CSSOM Tree 的,所以必须等待到CSSOM Tree构建完成后,才能开始渲染)
- css加载会阻塞后面 js 语句的执行(因为js可能会操作之前的Dom节点和css样式)
在CSS文件请求、下载、解析完成之前,CSS会阻塞渲染,浏览器将不会渲染任何已处理的内容
前面加载内联代码后,后面的外部引用css则没必要阻塞浏览器渲染。这时候就可以采取异步加载的方案,主要有如下:
- 使用javascript将link标签插到head标签最后
// 创建link标签 |
- 设置link标签media属性为noexis,浏览器会认为当前样式表不适用当前类型,会在不阻塞页面渲染的情况下再进行下载。加载完成后,将
media的值设为screen或all,从而让浏览器开始解析CSS
<link rel="stylesheet" href="mystyles.css" media="noexist" onload="this.media='all'"> |
- 通过rel属性将link元素标记为alternate可选样式表,也能实现浏览器异步加载。同样别忘了加载完成之后,将rel设回stylesheet
<link rel="alternate stylesheet" href="mystyles.css" onload="this.rel='stylesheet'"> |
选择器使用
- 不要嵌套使用过多复杂选择器,最好不要三层以上
- 使用 id 选择器就没必要再进行嵌套
- 通配符和属性选择器效率最低,避免使用
滚动视差
background-attachment: fixed
画三角形
宽高为零,三边透明,设置边框大小
.border { |
H5C3 新特性
H5 新增点
新增语义化标签
- header
- nav
- article
- section
- aside
- footer
- audio
- video
新增 localstorage,sessionstorage 本地存储
新增 DOM 查询: document.querySelector() / querySelectorAll()
CSS3 新特性
transition 过渡、animation 动画flex 弹性布局、Grid 栅格布局、媒体查询
过渡、文字、颜色、渐变
css3新增了三个边框属性,分别是:
- border-radius:创建圆角边框
- box-shadow:为元素添加阴影
- border-image:使用图片来绘制边框
新增了几个关于背景的属性,分别是background-clip、background-origin、background-size和background-break
过渡 + 动画css实现动画的方式,有如下几种:
- transition 实现渐变动画
/* property name | duration | timing function | delay */ transition: opacity 4s ease-in-out 1s;- 并不是所有的属性都能使用过渡的,如`display:none<->display:block`
- transform 转变动画
- translate:位移
- scale:缩放
- rotate:旋转
- skew:倾斜(斜切,音skill)
- 注意:`transform`不支持`inline`元素,使用前把它变成`block`
- ```html
transform: scale(0.8, 1.5) rotate(35deg) skew(5deg) translate(15px, 25px);
- animation 实现自定义动画
animation: rotate 2s;- ```css
@keyframes rotate{
from{
transform: rotate(0deg);
}
to{
transform: rotate(360deg);
}
}
SCSS
嵌套、混入、变量、函数
嵌套 { }
最简单的大括号嵌套,参考 JavaScript 写法
变量 $
变量名以$开头, 例如 $font-size: 12px;
- 使用变量时确保 / 不做除法运算, 而是完整地编译到 CSS 文件中,只需要用 #{} 插值语句将变量包裹。
p { |
混入 @mixin @include
用于样式复用, 在多页面与双主题色中常用
定义混合指令 @mixin
使用混合样式 @include
/* 定义 */ |
@extend 继承
在一般情况下,一个元素使用的样式与另一个元素完全相同,但又添加了额外的样式。通常会在 HTML 中给元素定义两个 class,一个通用样式,一个特殊样式。假设现在要设计一个普通错误样式与一个严重错误样式,一般会这样写:
<div class="error seriousError"> |
.error { |
麻烦的是,这样做必须时刻记住使用 .seriousError 时需要参考 .error 的样式,带来了很多不变:智能比如加重维护负担,导致 bug,或者给 HTML 添加无语意的样式。使用 @extend 可以避免上述情况,告诉 Sass 将一个选择器下的所有样式继承给另一个选择器。
.error { |
函数 - 内置控制指令 + 自定义函数指令
内置控制指令
Sass Script 提供了一些基础的控制指令,比如在满足一定条件时引用样式,或者设定范围重复输出格式。
- @if —— 当 @if 的表达式返回值不是 false 时,条件成立,输出 {} 内的代码:@if 声明后面可以跟多个 @else if 声明,或者一个 @else 声明。
$type: flower; |
- @for 指令可以在限制的范围内重复输出格式,每次按要求(变量的值)对输出结果做出变动。这个指令包含两种格式:
@for $var from <start> through/to <end>,当使用 through 时,条件范围包含 start 与 end 的值,而使用 to 时条件范围只包含 start 的值不包含 end 的值。另外,$var 可以是任何变量,比如 $i;start 和 end 必须是整数值。
@for $i from 1 through 3 { |
- @each 指令的格式是
$var in <list>, $var 可以是任何变量名,比如 $length 或者 $name,而 list 是一连串的值,也就是值列表。@each 将变量 $var 作用于值列表中的每一个项目,然后输出结果,例如:
@each $animal in puma, sea-slug, egret, salamander { |
- @while 指令重复输出格式直到表达式返回结果为 false。这样可以实现比 @for 更复杂的循环,只是很少会用到。例如:
$i: 6; |
自定义函数指令
Sass 支持自定义函数,并能在任何属性值或 Sass script 中使用。
建议在自定义函数前添加前缀避免命名冲突,其他人阅读代码时也会知道这不是 Sass 或者 CSS 的自带功能。
$grid-width: 40px; |
JavaScript
数据类型
- 基本数据类型存储在栈中 6 种
- 引用类型的对象存储于堆中 3 种
- 基本数据类型
- Number
- 可以设置八进制(零开头)、十六进制(0x开头)、可通过科学计数法表示 3.1e3; 等于 3100
NaN,意为“不是数值”,NaN != NaN
- String
- 字符串可以使用双引号(”)、单引号(’)或反引号(`)标示
- 字符串是不可变的,意思是一旦创建,它们的值就不能变了
let lang = "Java";
lang = lang + "Script";  // 先销毁再创建
- Boolean
- 以下 6 种情况皆为 false
- undefined
- null
- false
- 0
- NaN
- “” (空字符串)
- 特别注意,空数组 [ ] 和空对象 { } 对应的都是true。
- Undefined
- 声明了变量但没有初始化时,就相当于给变量赋予了
undefined值
- 声明了变量但没有初始化时,就相当于给变量赋予了
- null
- 逻辑上讲,null 值表示一个空对象指针,这也是给
typeof传一个null会返回"object"的原因。只要变量要保存对象,而当时又没有那个对象可保存,就可用null来填充该变量。let car = null;
console.log(typeof car); // "object"
<!-- `undefined` 值是由 `null`值派生而来 -->
console.log(null == undefined); // true
- 逻辑上讲,null 值表示一个空对象指针,这也是给
- symbol
- Symbol 是原始值,且符号实例是唯一、不可变的。符号的用途是确保对象属性使用唯一标识符,不会发生属性冲突的危险。
- 不支持语法:”
new Symbol()“ - 用途:作为对象属性名(key)、使用 Symbol 来替代常量(防止冲突)
const symbol1 = Symbol(); const symbol2 = Symbol(42); const symbol3 = Symbol('foo'); console.log(typeof symbol1); // Expected output: "symbol" console.log(symbol2 === 42); // Expected output: false console.log(symbol3.toString()); // Expected output: "Symbol(foo)" console.log(Symbol('foo') === Symbol('foo')); // Expected output: false- **引用数据**类型
若直接通过 arr2 = arr1 进行赋值,则对 arr2 的修改也会影响到 arr1,对象同理。
- 统称为`Object`对象类型,主要下面三种:(对象、数组、函数)
- Object
- Array
- Function(函数实际上也是对象)
- 除了上述说的三种之外,还包括`Set`、`Map`、`Date`、`RegExp`等。
`Set` 是一种叫做**集合**的数据结构,`Map`是一种叫做**字典**的数据结构
- `Set` 是一种只存储**值**的集合,它的特点是其中的值只会**唯一**出现一次。set 是一个对象而非数组,无法通过索引取值,遍历可以通过 for...of 或 forEach
- 用途:Set 数组去重
- ``` js
// set 集合去重
let uniqueArrays = (...arrays) =>
[...new Set(arrays.flat())] // 对传入的剩余参数数组扁平化一层处理,保留嵌套数组,如需完全打平可使用 .flat(Infinity)
let arr1 = [1, 1, 2, 3, 4, 3, 1];
let arr2 = [12, 1, 12, 13, 24, 33, 111];
let arr3 = uniqueArrays(arr1, arr2,[0,1,1,1,2,[123,123,1234]]);
console.log(arr3); // [1, 2, 3, 4, 12, 13, 24, 33, 111, 0, [123,123,1234]]
// set 是一个对象而非数组,无法通过索引取值,遍历可以通过 for...of 或 forEach
arr1 = [1, 1, 2, 3, 4, 3, 1]
let set1 = new Set(arr1)
console.log(set1) // Set(4) {1, 2, 3, 4}
let newArr = Array.from(set1) // 利用 Array.from 来将他转成真正的数组
console.log(newArr) // 此时他就是一个去重完毕的数组
// 也可以使用展开运算符进行去重
let newArr2 = [...set1]
console.log(newArr2)
let arr3 = [...new Set([...arr1,...arr2])]- Map
Map是一种存储键值对的集合,但与传统的对象(Object)不同,Map的键可以是任意类型,包括函数、对象或任何原始类型。- 用途:查找匹配时将对象数组转化为 Map 哈希表,降低时间复杂度。详见:最佳查找
- 与 Object 区别:
- Map 可以使用任意类型的值作为键,包括对象、函数等。而 Object 传统上只能使用字符串或者
Symbol作为键。 - Map 对于频繁增删键值对的场景,
Map有更优的性能。Object 当作为大量属性的简单集合时,访问速度可能会很快,但是在属性的频繁增删中性能可能不如 Map。
- Map 可以使用任意类型的值作为键,包括对象、函数等。而 Object 传统上只能使用字符串或者
- Number
数组操作 ⭐
增
- push() 接收任意,末尾添加,返回新数组长度
- unshift() 开头添加任意,返回新数组长度
- splice() 传入三个参数,分别是开始位置、0(要删除的元素数量)、插入的元素,返回空数组
- concat() 首先会创建一个当前数组的副本,然后再把它的参数添加到副本末尾,最后返回这个新构建的数组,不会影响原始数组
let colors = ["red", "green", "blue"];
let colors2 = colors.concat("yellow", ["black", "brown"]);
console.log(colors); // ["red", "green","blue"]
console.log(colors2); // ["red", "green", "blue", "yellow", "black", "brown"]
删
- pop() 删除数组的最后一项,返回被删除的项
- shift() 删除数组的第一项,返回被删除的项
- splice() 传入两个参数,(开始位置,删除元素的数量),返回包含删除元素的数组
["Jan", "Feb", "March", "April", "June"].splice(4, 1, 'May');
console.log(months); // 从第四个元素开始[包括],删去一个元素,增加'May'
// Expected output: Array ["Jan", "Feb", "March", "April", "May"] - slice() 从某处开始截取,左闭右开,若不输入参数从0开始截取(即数组不变)
let colors = ["red", "green", "blue", "yellow", "purple"];
let colors2 = colors.slice(1);
let colors3 = colors.slice(1, 4);
concole.log(colors2); // green,blue,yellow,purple
concole.log(colors3); // green,blue,yellow
改
splice() 传入三个参数,分别是开始位置,要删除元素的数量,要插入的任意多个元素,返回删除元素的数组,对原数组产生影响
let colors = ["red", "green", "blue"]; |
查
- indexOf() 用法
Array.indexOf('查找元素')返回要查找的元素在数组中的位置,如果没找到则返回 -1 - includes() 用法
Array.includes(searchElement, fromIndex)返回要查找的元素在数组中的位置,找到返回true,否则false - find(callbackFn) 返回第一个匹配的元素,参数是一个函数
const array1 = [
  { name: "apples", quantity: 2 },
  { name: "bananas", quantity: 0 },
  { name: "cherries", quantity: 5 },
];
const result = array1.find(({ name }) => name === "cherries");
排序方法
数组有两个方法可以用来对元素重新排序:
- reverse() 将数组元素方向反转(原地算法,会改原数组)
let values = [1, 2, 3, 4, 5]; values.reverse(); alert(values); // 5,4,3,2,1- sort(fn) 方法接受一个比较函数 fn,用于判断哪个值应该排在前面
- ```js
// 升序排序 a-b
function compareNumbers(a, b) {
return a - b;
}- 如果不传参数,则按字符编码排序
常见方法
以下方法都不改变原数组
- for of 遍历数组
- for in 遍历对象
- forEach() 对数组每一项都运行传入的函数,没有返回值(操作在函数内部完成此次)
- map() 返回值为每次函数调用结果所构成的数组
- some() 至少有 1 个元素返回 true,则该方法返回 true
- every() 所有元素都返回 true ,则这个方法才返回 true
- filter() 返回值为测试函数中,返回 true 的项组成的数组。
- obj.filter(Boolean) 可以用于过滤假值。当你写下 filter(Boolean) 时,Boolean 函数作为回调函数传递给 filter 方法。因为 filter 方法接收一个函数,在遍历数组时会将每个元素传递给这个函数,并根据返回值(true 或 false)决定是否保留该元素。Boolean 函数将所有假值转换为 false,将所有真值转换为 true。
- reduce() 对数组进行遍历,reduce 函数的第一个参数得到的是迭代计算后的结果
reduce 详解
reduce(callbackFn) |
使用方法
const initialValue = 10 |
使用场景
- 求和/求乘积
[1,2,3,4,5].reduce((a,b) => a + b) //15 |
- 记录某个元素在数组中出现了几次
['name','age','long','long','name'].reduce((pre,cur) =>{ |
for in 与 for of 的区别
for in 遍历对象
for of 遍历数组
const object = { a: 1, b: 2, c: 3 }; |
- for in 只能遍历到数组的索引,无法获取到数组元素,for of 遍历的是数组元素值。
- for of 不支持遍历普通对象(因为普通对象内部没有 Symbol.iterator,是不可迭代的[没有 next() 方法]),除此之外可以遍历‘字符串、数组、Set、Map、Arguments、迭代生成器’等等
如果想遍历对象的属性名,可以用 for in 循环
但 for in 会遍历整个原型链,推荐使用内置的 Object.keys() 方法
Object.keys() | values() | entries()
- Object.keys() 返回自身的(不含继承的)所有可遍历属性的键名的数组
- Object.values() 返回自身的(不含继承的)所有可遍历属性的值的数组
- Object.entries() 返回由[key, value]组成的二维数组
keys()是对键名的遍历、values()是对键值的遍历,entries()是对键值对的遍历
const obj = { |
Array.includes()
用于判断数组是否包含给定的值
[1, 2, 3].includes(2) // true |
方法的第二个参数表示搜索的起始位置,默认为0
参数为负数则表示倒数的位置
[1, 2, 3].includes(3, 3); // false |
两个对象数组 查找匹配
filter + some(object.id) 对象操作
+ includes(array) 数组操作
找出 arr1 中那些 id 值在 arr2 中也存在的对象
// 对象数组 => 对象数组 |
哈希表 - 最佳查找
上面的方法时间复杂度是 O(n*m),可以通过哈希表优化到 O(n+m)(也就是O(n))
将 data 转换为一个对象,来进行 O(1) 时间复杂度的查找。
- 首先将
data转换为键值对格式的对象。 - 然后针对
selected数组快速查找对应的值。
const data = [ |
数组扁平化 flat() flatMap()
const arr = [1, 2, [3, 4], [5, [6, 7]]]; |
flatMap() 方法对原数组的每个成员执行一个函数相当于执行Array.prototype.map(),然后对返回值组成的数组执行flat()方法。该方法返回一个新数组,不改变原数组(先 map,再对返回值进行 flat)
// 相当于 [[2, 4], [3, 6], [4, 8]].flat() |
扩展运算符 …
用于取出参数对象中的所有可遍历属性,拷贝到当前对象之中
可以将字符串转为真正的数组
[...'hello'] |
Array.from()
将两类对象转为真正的数组:
- 类似数组的对象(包括伪数组)
- 可遍历的对象(包括
Set和Map)
let arrayLike = { |
还可以接受第二个参数,用来对每个元素进行处理,将处理后的值放入返回的数组
Array.from([1, 2, 3], (x) => x * x) |
join()
方法接收一个参数(字符串分隔符),返回包含所有项的字符串
let colors = ["red", "green", "blue"]; |
字符串 - 常用方法
split()
把字符串按照指定的分割符,拆分成数组中的每一项
let str = "12+23+34" |
parseInt
将一个字符串转换为整数
- 忽略空格
- 解析到非数字停止
- 对浮点数直接取整(同上,解析到小数点.截止)
- 如果第一个就是非数字,返回 NaN
parseInt(string, radix);
string:要被解析的字符串。如果该参数不是字符串,则将其转换为字符串,在转换过程中会去掉开头的空格字符。
radix:一个介于 2 到 36 之间的整数,表示被解析的数字的基数(数学中的进制)。如果省略该参数,则在大多数情况下基数默认为 10。
console.log(parseInt("123")); // 输出:123 |
concat()
用于将一个或多个字符串拼接成一个新字符串
"hello ".concat("world"); // 'hello world' |
string.trim()
用于删除字符串前后缀空格
repeat()
用于重复字符串
let copyResult = 'na'.repeat(2) // nana |
toLowerCase() toUpperCase()
字符串大小写转换
charAt()
返回给定索引位置的字符。
如果 index 超出范围,charAt() 返回一个空字符串
indexOf()
从字符串开头去搜索传入的字符串,并返回位置(没找到返回 -1 )
startWith()
判断当前字符串是否以另外一个给定的子字符串开头,并根据判断结果返回 true 或 false。
includes()
从字符串中搜索传入的字符串,并返回一个表示是否包含的布尔值
match()
接收一个参数,可以是一个正则表达式、字符串,也可以是一个RegExp对象,返回匹配上的数组
let text = "cat, bat, sat, fat"; |
search()
接收一个参数,可以是一个正则表达式字符串,也可以是一个RegExp对象,找到则返回第一个匹配索引,否则返回 -1
let text = "cat, bat, sat, fat"; |
replace()
接收两个参数,第一个参数为匹配的内容,第二个参数为替换的元素(可用函数),只会替换第一个
let text = "cat, bat, sat, fat"; |
剩余参数和 arguments 对象的区别
- 剩余参数只包含那些没有对应形参的实参;而 arguments 对象包含了传给函数的所有实参。
- arguments 对象是伪数组,除了 length 属性和索引元素之外没有任何 Array 属性;而剩余参数是真数组,也就是说你能够在它上面直接使用所有的数组方法,比如 sort,map,forEach或pop。
- 剩余参数需要在传参时标注 (…theArgs) 后才能使用,arguments 能直接使用。
- arguments对象还有一些附加的属性(如callee属性)。
label 语句
配合 break
箭头函数不同点
- 箭头函数没有独立的 this、arguments 和 super 绑定,并且不可被用作方法。
- 箭头函数不能用作构造函数。使用 new 调用它们会引发 TypeError。它们也无法访问 new.target 关键字。
- 箭头函数不能在其主体中使用 yield,也不能作为生成器函数创建。
?? 非空可选运算符
?? 非空运算符 (当左侧的操作数为 null 或 undefined时,返回其右侧操作数,否则返回左侧操作数)。注意不同点:逻辑或运算符 || 会在左侧操作数为假值(’’ 或 0 等)时返回右侧操作数。
?. 可选链式运算符
?. 可选链式运算符 (在引用为空[nullish](比如 null 或者 undefined) 时不会引起错误导致程序运行中断,该表达式短路返回值是 undefined)
== 与 ===
== 等于操作符
JavaScript中存在隐式转换。等于操作符(==)在比较中会先进行类型转换,再确定操作数是否相等
// NaN 不等于 NaN |
如果两个操作数都是对象,则比较它们是不是同一个对象。如果两个操作数都指向同一个对象,则相等操作符返回true
let obj1 = {name:"xxx"} |
=== 全等操作符
undefined 和 null 与自身严格相等
let result1 = (null === null) // true |
但在比较null的情况的时候,我们一般使用相等操作符==
const obj = {}; |
所以,除了在比较对象属性为null或者undefined的情况下,我们可以使用相等操作符(==),其他情况建议一律使用全等操作符(===)
浅拷贝与深拷贝
浅拷贝
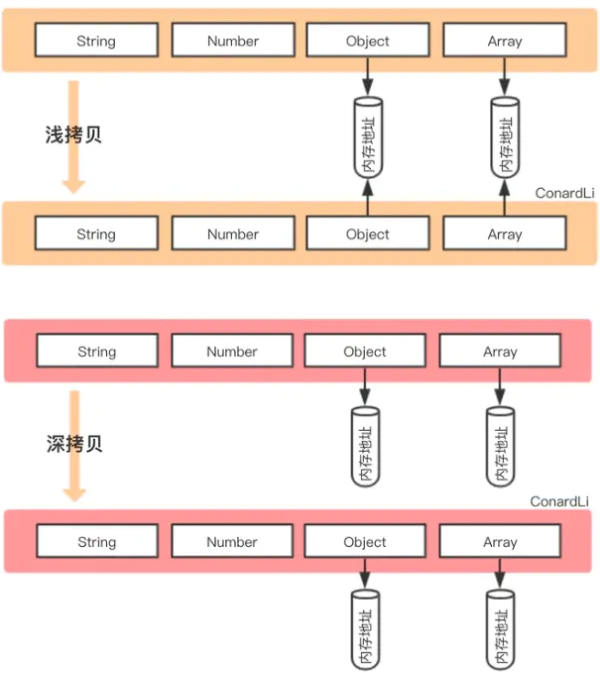
浅拷贝指的是创建新的数据,这个数据有着原始数据属性值的一份精确拷贝
如果属性是基本类型,拷贝的就是基本类型的值。如果属性是引用类型,拷贝的就是内存地址。
即浅拷贝是拷贝一层,深层次的引用类型则共享内存地址(所以修改拷贝项会影响到原数组或对象)
function shallowClone(obj) { |
在JavaScript中,存在浅拷贝的现象有:
- 直接复制
- Object.assign({}, originObj)
- Array.prototype.slice() | arr.slice(0)
- Array.prototype.concat() | arr.concat()
- … 使用拓展运算符实现的复制 | arr2 = […arr]
深拷贝
深拷贝在堆上分配新内存,两个对象属完成相同,但是对应两个不同的地址,修改一个对象的属性,不会改变另一个对象的属性
常见的深拷贝方式有:
- _.cloneDeep() 【使用 lodash 库】
- jQuery.extend() 【使用 jQuery库】
- JSON.stringify() 【会丢失 undefined 等属性,并且两个对象如果存在循环引用的属性会直接导致栈溢出】
// 先转换为 JSON 字符串,再转为对象
const obj2=JSON.parse(JSON.stringify(obj1));
<!-- ⚠ 但这样做会丢失`undefined`、`symbol`和`函数`的属性 -->
const obj = {
    name: 'A',
    name1: undefined,
    name3: function() {},
    name4:  Symbol('A')
}
const obj2 = JSON.parse(JSON.stringify(obj));
console.log(obj2); // {name: "A"} 只剩下 A - 手写循环递归 obj.hasOwnProperty(key)
function deepClone(obj, hash = new WeakMap()) {
  if (obj === null) return obj; // 如果是null或者undefined我就不进行拷贝操作
  if (obj instanceof Date) return new Date(obj);
  if (obj instanceof RegExp) return new RegExp(obj);
  // 可能是对象或者普通的值  如果是函数的话是不需要深拷贝
  if (typeof obj !== "object") return obj;
  // 是对象的话就要进行深拷贝
  if (hash.get(obj)) return hash.get(obj);
  let cloneObj = new obj.constructor();
  // 找到的是所属类原型上的constructor,而原型上的 constructor指向的是当前类本身
  hash.set(obj, cloneObj);
  for (let key in obj) {
    if (obj.hasOwnProperty(key)) {
      // 实现一个递归拷贝
      cloneObj[key] = deepClone(obj[key], hash);
    }
  }
  return cloneObj;
}
执行上下文
用来描述JavaScript代码被解析和执行时环境的状态。可以将它理解为当前JavaScript代码运行时的环境,这个环境中包含了所有必需的信息,以便代码可以顺利执行。每当JavaScript代码执行一段可执行代码时,都会创建对应的执行上下文。
通俗地讲,执行上下文就像是一个包含了所有你需要知道的信息的盒子,以便你的代码可以运行。这个“盒子”包括了变量、函数声明、this 的值、外部环境的引用等。
- 全局执行上下文:这是最基础的上下文,任何不在函数内部的代码都在全局上下文中。它会创建一个全局对象(在浏览器中是
window对象),并且将this设置为这个全局对象。一个程序中只会有一个全局执行上下文。 - 函数执行上下文:每当一个函数被调用时,就会为该函数创建一个新的执行上下文。这个上下文包含了函数的参数,局部变量,以及
this的值。 - Eval 函数执行上下文: 指的是运行在
eval函数中的代码,很少用而且不建议使用
this ⭐
- 在函数运行时才生成并绑定的一个内部对象
- 总指向调用它的对象
- 值取决于它出现的上下文:函数、类或全局
call、apply、bind作用是改变函数执行时的上下文(改变函数运行时的this指向)
var name = "lucy"; |
从上面可以看到,正常情况say方法输出martin
但是我们把say放在setTimeout方法中,在定时器中是作为回调函数来执行的,因为 this 在函数运行时才生成并绑定,因此回到主栈执行时是在全局执行上下文的环境中执行的,这时候this指向window,所以输出lucy
我们实际需要的是this指向obj对象,这时候就需要该改变this指向了
setTimeout(obj.say.bind(obj),0); // martin,this 指向 obj 对象 |
call,apply,bind 详解
三者都可以改变函数的this对象指向
执行:
call() 、apply() 会立即执行。
bind() 会返回绑定 this 后的新函数,需要调用它才会执行。
传参:
三者第一个参数都是this要指向的对象,如果没有这个参数或参数为undefined或null,则默认指向全局window【第二个及以后的参数作为函数体的参数传入】
call() 传入的是参数列表(可以传好几个参数)
apply() 传入的是一个数组
bind() 可以分为多次传入参数,也可以传入参数列表
const [c1, c2] = ['B', 'C'] |
箭头函数没有自己的 this 上下文,继承的是上一个代码作用域的 this
// 在这个例子中,innerFunc 是一个箭头函数,它从 sayName 函数中继承了 this 的值,所以 this 指向 obj。 |
节流 和 防抖 ⭐
节流 throttle
- n 秒内只运行一次,若在 n 秒内重复触发,只有一次生效(类似技能 CD)
- 滚动加载,加载更多或滚到底部监听
- 刷新按钮
function throttle(fn, delay) {
  let last = 0;
  return function() {
    let now = Date.now();
    if (now - last > delay) {
      last = now;
      fn.apply(this, arguments);
    }
  };
}- n 秒内只运行一次,若在 n 秒内重复触发,只有一次生效(类似技能 CD)
防抖 debounce
- n 秒后再执行该事件,若在 n 秒内被重复触发,则重新计时(类似抖动打断回城)
- 搜索框搜索输入推荐。用户输入不动后,再发送请求
- 手机号、邮箱输入合法性检测
function debounce(func, wait) {
  let timeout; // 内部函数可以访问到外部变量
  return function() {
      const context = this;
      const args = arguments;
      clearTimeout(timeout); // 抖动时重设定时器
      timeout = setTimeout(() => func.apply(context, args), wait);
  };
}- n 秒后再执行该事件,若在 n 秒内被重复触发,则重新计时(类似抖动打断回城)
闭包⭐
闭包的详细介绍 function - How do JavaScript closures work? - Stack Overflow
定义
闭包是一种特殊的函数。允许函数内部访问并操作该函数外部作用域中的变量,但外部不能访问函数内的局部变量
在 JavaScript中,每当创建一个函数,闭包就会在函数创建的同时被创建出来,作为函数内部与外部连接起来的一座桥梁
下面给出一个简单的例子
function init() { |
displayName() 没有自己的局部变量。然而,由于闭包的特性,它可以访问到外部函数的变量
作用
创建私有变量:在JavaScript中,可以使用闭包来模拟私有变量的功能,使得这些变量只能通过特定的函数访问和修改。
防抖和节流函数:在处理DOM事件时,闭包常用于实现防抖和节流功能,以优化性能
闭包允许函数记住其外部作用域的状态。
function debounce(func, wait) { |
延长变量的生命周期:一般函数的词法环境在函数返回后就被销毁,但是闭包会保存对创建时所在词法环境的引用,即便创建时所在的执行上下文被销毁,但创建时所在词法环境依然存在,以达到延长变量的生命周期的目的
函数柯里化:将一个接受多个参数的函数转换成一系列使用一个参数的函数。,它使得我们可以逐步地提供参数
// 原函数 |
函数工厂:可以用闭包来创建设置特定参数的函数,这些函数可以用于不同的上下文但又保持一定的通用性。
模块化代码:闭包可以用来创建模块,其中包含公开的方法和私有的数据,这有助于代码的组织和封装。
function createCounter() { |
在这个例子中,createCounter函数返回了一个匿名函数,这个匿名函数可以访问createCounter函数内部的count变量。即使createCounter的执行上下文已经结束,通过闭包,返回的函数仍然可以访问和修改count变量。这就是闭包的强大之处。
原型与原型链 ⭐
每个对象拥有一个原型对象,当试图访问一个对象的属性时,它不仅仅在该对象上搜寻,还会搜寻该对象的原型,以及该对象的原型的原型,依次层层向上搜索,直到找到一个名字匹配的属性或到达原型链的末尾
准确地说,这些属性和方法定义在 Object 的构造器函数(constructor functions)之上的prototype属性上,而非实例对象本身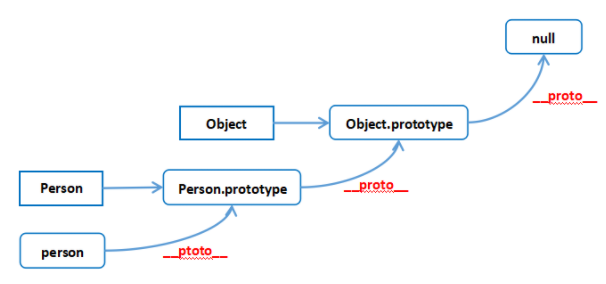
// 每个对象的`__proto__`都是指向它的构造函数的原型对象`prototype`的 |
总结
- 一切对象都是继承自
Object对象,Object对象直接继承根源对象null - 所有的构造函数(可以 new 的大类)都是函数对象,都是通过
Function构造器产生的 Function创造了函数对象,也创造了构造函数,也创造了自己。
Q:为什么构造函数的方法要写在原型中而不是直接写在构造函数中,两种方式有什么区别?
A:把方法定义在构造函数中,创建多个实例时则要创建多个方法。每个实例化的对象都有单独的方法,太占用内存。
把方法定义在prototype中,通过该构造函数创建的实例拥有的方法实际上是都指向这个方法的指针。所以占用内存的只有一个方法,可以节省内存。
typeof 与 instanceof 区别
typeof 和 instanceof 都是用于判断数据类型的运算符,但有不同的用途和行为。
typeof 用于判断一个变量或表达式的原始类型或对象类型。操作符返回一个字符串,表示类型信息。instanceof 用于测试对象类型,判断一个对象是否是某个构造函数的实例。可以检测构造函数的 prototype 属性是否出现在某个实例对象的原型链上
let str = 'xxx' |
事件委托
给父层元素绑定事件,通过判别 e.target.nodeName 的名称是否为想要的标签名来委托事件。
// 给父层元素绑定事件 |
尾递归优化
在尾递归中,递归调用是函数中的最后一个操作,这意味着函数的结果是直接返回这个递归调用的结果,而不需要进一步的计算。这使得在实现上可以在当前调用帧中直接重用这个帧而不需要增加新的调用帧,减少程序运行时的调用栈大小,从而减少内存的使用。
实现一下阶乘,如果用普通的递归,如下:
function factorial(n) { |
如果n等于5,这个方法要执行5次,才返回最终的计算表达式,这样每次都要保存这个方法,就容易造成栈溢出,复杂度为O(n)
如果我们使用尾递归,则如下:
function factorial(n, total) { |
可以看到,每一次返回的都是一个新的函数,而不需要带上一个函数的参数,也就不需要储存上一个函数了。尾递归只需要保存一个调用栈,复杂度 O(1),新栈可以直接覆盖使用当前栈,不需要开辟新空间
通过在尾递归函数中使用累积参数来保存中间结果,并在递归调用时更新参数值,可以实现尾递归优化。
本地存储 cookies | sessionStorage | localStorage
- 标记用户与跟踪用户行为的情况,推荐使用
cookie - 适合长期保存在本地的数据(令牌),推荐使用
localStorage - 敏感账号一次性登录,推荐使用
sessionStorage - 存储大量数据的情况、在线文档(富文本编辑器)保存编辑历史的情况,推荐使用
indexedDB
自动携带
- cookie 数据始终在同源的 http 请求中携带(即使不需要),即会在浏览器和服务器间来回传递
- 而 sessionStorage 和 localStorage 不会主动把数据发给服务器,仅在本地保存
存储大小
- cookie 数据大小不能超过 4k
- sessionStorage 和 localStorage 可以达到 4mb 以上
有期时间
- cookie 在设置的过期时间之前一直有效,即使窗口或浏览器关闭
- localStorage 存储持久数据,浏览器关闭后数据不丢失除非主动删除数据
- sessionStorage 数据在当前浏览器窗口关闭后自动删除
- 页面会话在浏览器打开期间一直保持,并且重新加载或恢复页面仍会保持原来的页面会话。
- 在新标签或窗口打开一个页面时会复制顶级浏览会话的上下文作为新会话的上下文,这点和 session cookie 的运行方式不同。
- 打开多个相同的 URL 的 Tabs 页面,会创建各自的
sessionStorage。 - 关闭对应浏览器标签或窗口,会清除对应的
sessionStorage。
1、不同浏览器无法共享 localStorage 和 sessionStorage 的值。
2、相同浏览器下,并且是同源窗口(协议、域名、端口一致),不同页面可以共享 localStorage,Cookies 值,通过跳转的页面可以复制(而非共享,数据间不会污染)sessionStorage 值。(跳转方式如a链接, window.location.href,路由跳转)
cookie
cookie 是网站为了标示用户身份而储存在用户本地终端上的数据(通常经过加密)
是为了解决
HTTP无状态导致的问题(无状态:每次 HTTP 请求都是独立的,服务器不会记住之前客户端的请求信息)可以存储登录信息/会话状态管理,个性化设置,浏览器行为跟踪
document.cookie = '名字=值'; // 设置 cookie
let getCookies = document.cookie; // 将以字符串格式返回所有的 cookie,例如: cookie1=value; cookie2=value; cookie3=value;

// Expires 用于设置 Cookie 的过期时间
Expires=Wed, 21 Oct 2015 07:28:00 GMT
// Max-Age 用于设置在 Cookie 失效之前需要经过的秒数(优先级比`Expires`高)
Max-Age=604800

// 修改时会直接覆盖旧数据
// 如果需要删除 cookie 一般通过设置过期时间(设置一个之前的时间 1970 年)
Web Storage(包含 localStorage 和 sessionStorage)
- 大小:5M(跟浏览器厂商有关系)
- 只能存储字符串,无法直接存储对象(需要转化)
localStorage
- 默认不会过期,除非主动删除数据,否则数据永远保存在本地存储
localStorage.setItem('username','cfangxu'); |
sessionStorage
- 页面生命周期:页面/会话关闭,
sessionStorage将删除数据 sessionStorage和localStorage使用方法基本一致
indexedDB
indexedDB是一种低级API,用于客户端存储大量结构化数据(包括, 文件/blobs)。该API使用索引来实现对该数据的高性能搜索- 储存量理论上没有上限
- 所有操作都是异步的,相比
LocalStorage同步操作性能更高,尤其是数据量较大时 - 原生支持储存
JS的对象 - 是一个数据库
精度问题
1 + 0.2 == 1.2 // true |
在javascript语言中,0.1 和 0.2 都转化成二进制后再进行运算
可以将浮点数转为 小数部分 与 整数部分 分别计算
大数计算 - bignumber.js 库
- 转为字符串计算,模拟手工乘法与长除法
Promise
Promise 是一个对象,它代表一个即将完成(或者失败)的异步操作,并且最终会返回一个结果(或者一个错误)。可以把它看作是对未来值的一种承诺:现在没有这个值,但未来会有。
Promise 就是为了解决异步操作产生的回调地狱而产生的,将回调函数的嵌套,改成链式调用
- Pending(进行中):初始状态,既没有成功也没有失败。
- Fulfilled(已成功):操作成功完成。
- Rejected(已失败):操作失败。
axios 基于 Promise。使用 axios 发送请求时,它会返回一个 Promise 对象。
创建一个 Promise
可以通过new Promise来创建一个 Promise 对象。这个 Promise 对象需要一个“执行器函数”(executor function),这个函数有两个参数:resolve和reject。下面是一个简单的例子:
const myPromise = new Promise((resolve, reject) => { |
使用 Promise
then() 方法
then() 方法可以接收两个参数:一个处理成功resolve,一个处理失败reject。
但通常我们更倾向于用 .catch() 方法来处理失败的情况,以使代码更清晰。
promise.then(onFulfilled, onRejected); |
catch() 方法
但通常我们更倾向于用 .catch() 方法来处理失败的情况,以使代码更清晰。catch方法专门用于处理失败的情况,相当于then的第二个参数。
myPromise |
finally() 方法
finally 方法无论Promise是成功还是失败都执行。这在清理操作中非常有用。
myPromise |
链式调用
Promise 的这些方法返回的也是一个新的Promise对象,这允许我们进行链式调用,处理一系列的异步操作。
new Promise((resolve) => { |
静态方法
Promise.resolve()
直接创建一个成功的Promise。
Promise.resolve("立即成功").then((message) => { |
Promise.reject()
直接创建一个失败的Promise。
Promise.reject("立即失败").catch((message) => { |
Promise.all()
它接收一个 Promise 对象的数组并返回一个新的 Promise。这个新的 Promise 在数组中的所有 Promise 都成功时成功,如果有任何一个 Promise 失败了,它就失败。
Promise.all([ |
Promise.allSettled()
Promise.allSettled() 方法接受一个包含多个 Promise 的数组,并返回一个新的 Promise。当这些 Promise 全部都已被处理(无论是 resolve 还是 reject)时,返回的 Promise 将会被 resolve,并带有一个对象数组,每个对象表示对应的 Promise 的结果。
const promises = [ |
Promise.race()
它接收一个 Promise 对象的数组并返回一个新的 Promise。这个新的 Promise 会在数组中任何一个 Promise 成功或失败时立刻完成。因为失败也会导致完成,因为在资源竞速请求时应该采用另外一个 Promise.any()
Promise.race([ |
Promise.any()
Promise.any() 方法接受一个包含多个 Promise 的数组,并返回一个新的 Promise。只要其中的一个 Promise 被 resolve,返回的 Promise 就会被 resolve,并带有该 Promise 的值。如果所有的 Promise 都被 reject,返回的 Promise 才会被 reject,并带有一个 AggregateError,其中包含所有 Promise 的错误信息。
const promises = [ |
方法总结
- Promise.all():(等全成功才成功,有失败立刻失败)等待所有 Promise 完成(全是 resolve),并以数组形式返回结果;如果有一个 Promise 被 reject,则立即 reject。
- Promise.allSettled():(等所有结果,无论成败)等待所有 Promise 完成(无论是 resolve 还是 reject),并以对象数组形式返回每个 Promise 的结果。
- Promise.race():返回第一个完成(无论成败)的 Promise(无论是 resolve 还是 reject)。
- Promise.any():返回第一个成功(resolve)的 Promise 结果;如果所有 Promise 都被 reject,则返回 AggregateError。
async/await
async/await 基于 Promises,是用于处理异步编程的语法糖,能够让异步代码看起来更像是同步代码。
是 Promise 的语法糖,将函数变为异步函数,并且看上去是同步执行
async 函数
async 关键字用于将函数声明为异步函数。一个标记为 async 的函数会返回一个 Promise 对象,其返回值会被自动封装在一个 Promise.resolve() 中。
// 通过 async 将函数声明为异步函数 |
在上述示例中,greet 函数返回 “Hello”,由于它是使用 async 关键字声明的,所以它实际返回的是一个 Promise 对象,这个对象被解析并返回字符串 “Hello”。
await 表达式
await 关键字只能在 async 函数内使用,用于等待一个 Promise 对象被解决(resolve)。它会暂停 async 函数的执行,直到 Promise 被解决,然后恢复函数的执行并返回 Promise 的解决值。
function resolveAfter2Seconds() { |
在上述示例中,asyncCall 函数先打印 “Calling…”,然后等待 resolveAfter2Seconds 函数的 Promise 被解决,再打印 “Resolved”。
错误处理
使用 async/await 可以很方便地使用 try/catch 块进行错误处理。(在 promise 中使用 .then() 和 .catch() 进行错误处理)
async function asyncCall() { |
并行执行
由于 await 会暂停异步函数的执行,因此如果有多个 Promise 可以并行执行的话,最好不要在它们之间使用 await。
可以利用 Promise.all 来并行执行多个 Promise。
async function parallelExecution() { |
在以上示例中,promise1 和 promise2 会并行执行,并且会同时等待它们都完成后才执行后续逻辑。
生成器函数 function* 与 yield
生成器函数和 yield 主要用于控制函数的执行过程和处理异步编程。
需要特别注意的是:箭头函数不能用来定义生成器(它们不会创建自己的 this 上下文,而是继承自外部上下文。这种行为与生成器的设计目标不兼容,因为生成器需要能够在调用 next() 方法时管理自己的执行状态)
生成器函数
生成器函数是使用 function* 语法定义的特殊类型函数。与普通函数不同,生成器函数可以在执行过程中暂停,并在以后恢复执行。这种特性使得生成器函数非常适合处理需要逐步执行的任务,比如迭代、异步流控制等。
function* generatorFunction() { |
yield 关键字
yield 是生成器函数中的一个关键字,用于暂停函数执行并返回一个值给外部调用者。每当生成器函数遇到 yield 表达式时,它会暂停执行并将 yield 后面的值返回给调用方。调用方可以使用生成器对象的 next() 方法来恢复执行,继续从上一个 yield 停止的地方开始执行。
function* simpleGenerator() { |
在这个例子中,生成器函数 simpleGenerator 在每次 yield 时返回一个值,并暂停执行。
当 next() 方法被调用时,它会恢复执行直到下一个 yield,或者直到函数结束。
生成器的特点和优势
- 惰性执行: 只有在调用
next()方法时,生成器函数才会执行下一步。这使得生成器非常适合处理大数据集或无限序列,因为它们可以逐步产生值,而不是一次生成所有结果。 - 状态保持: 生成器函数在暂停时会保存其执行上下文。这意味着它可以记住它在什么时候停止,并在之后恢复执行时从同一点继续。
- 简化异步编程: 使用生成器和
yield可以模拟协程,从而简化异步代码的写法,特别是在结合Promise时,可以极大地简化异步流程控制。
示例:斐波那契数列生成器
下面是一个使用生成器函数生成斐波那契数列的例子:
function* fibonacci() { |
生成器函数 fibonacci 在每次调用 next() 时生成一个新的斐波那契数,而不是一次性计算所有数列。
迭代器 Iterator
迭代器(Iterator)是一种对象,它提供了一种机制来遍历(迭代)集合中的元素,来逐个访问一个集合(比如数组、字符串等)中的元素。
迭代器主要由两个部分组成:
- 迭代器协议:任何实现了 next() 方法的对象都可以被认为是一个迭代器对象。next() 方法返回一个对象,该对象具有两个属性:value:表示当前迭代到的值。done:一个布尔值,表示是否已经遍历完集合。
- 可迭代协议:一个对象如果实现了 @@iterator 方法(即对象有一个 Symbol.iterator 属性),那么该对象就是可迭代的。这个方法不接受参数,返回一个迭代器对象。
next() 方法:这是迭代器的核心方法。每次调用 next(),它会返回一个对象,这个对象有两个属性:
value:当前的值。done:一个布尔值(true或false),表示是否已经遍历完所有元素。
假设我们有一个数组,想要一个个地访问每个元素:
function createIterator(array) { |
在这个例子中,我们通过 createIterator 函数创建了一个迭代器,可以逐步访问数组中的元素。
使用 for...of 循环
JavaScript 提供了 for...of 循环,简化了迭代可迭代对象的过程。它会自动调用对象的迭代器。(所以 for of 无法迭代普通对象,因为普通对象默认没有 Iterator 接口)
const array = ['x', 'y', 'z']; |
自定义可迭代对象
如果你有一个自定义对象,也可以让它变得可迭代,只需为它实现 Symbol.iterator 方法即可。
const myIterable = { |
ES6 新特性
- let、const
- Symbol、Map、Set
- 解构赋值
- 模板字符串``
- 字符串方法
- includes()
- startsWith()
- endsWith()
- 数组方法
- …运算符拓展
Array.from()将类数组转化数组Array.fill()填充数组entries(),keys()和values()遍历数组/对象includes()表示某个数组是否包含给定的值Array.find()和findIndex()[都是传入一个函数]- Array.flat(n) 数组扁平化
- Promise对象
- async/await 函数
- Genertor 生成器
- Iterator 迭代器
- class 与 继承
- Module 模块导入导出
- 尾后逗号在 es5 中引入,但 JSON 基于 es5 之前的语法,因此不支持尾后逗号
Vue
Vue3 新特性
- compositon Api
- 更好的实现代码的逻辑提取与复用,就像 Vue2 中的 mixin 存在局限性(代码量上升后会导致很难追踪一个特定的属性方法来自哪个 mixin)
- 使用 Proxy 替代 Vue2 中的 Object.defineProperty 实现数据响应式
- 为什么替代?因为
definePropertyAPI 的局限性最大原因是它只能针对单例属性做监听。Vue2 中的响应式实现正是基于 defineProperty 中的 descriptor,对 data 中的属性做了遍历 + 递归,为每个属性设置了 getter、setter。(这样性能也不好【第二个点】)
这也就是为什么 Vue 2只能对 data 中预定义过的属性做出响应的原因,在 Vue 中使用下标的方式直接修改属性的值或者添加一个预先不存在的对象属性是无法做到 setter 监听的,这是 defineProperty 的局限性。
而 Proxy API 的监听是针对一个对象的,那么对这个对象的所有操作会进入监听操作, 这就完全可以代理所有属性,将会带来很大的性能提升和更优的代码。
Proxy 可以理解成,在目标对象之前架设一层 “拦截”,外界对该对象的访问,都必须先通过这层拦截,因此提供了一种机制,可以对外界的访问进行过滤和改写。
diff算法优化
- Vue2 的
diff算法叫做全量比较,顾名思义,就是当数据改变的时候,会从头到尾的进行vDom对比,即使有些内容是永恒固定不变的。 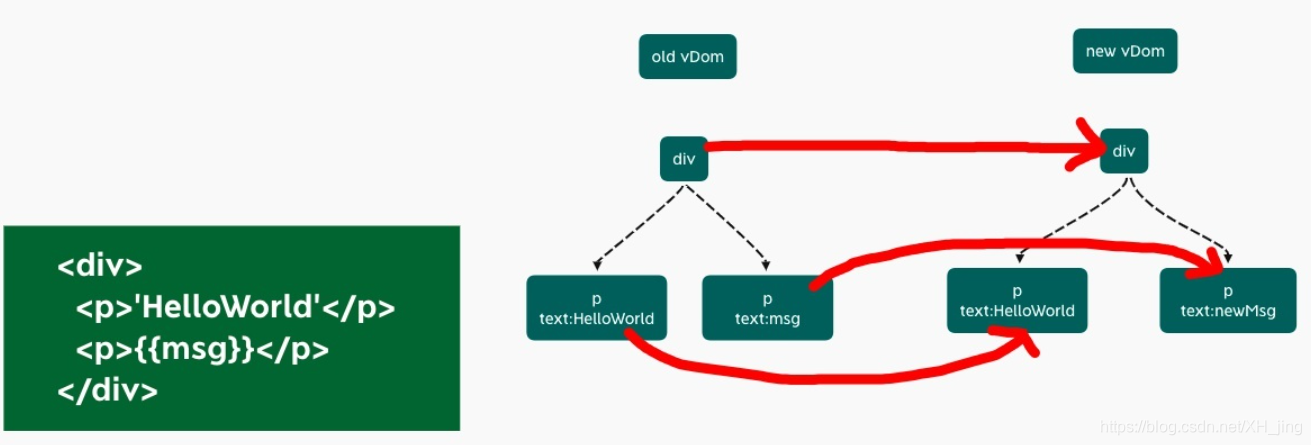
- Vue3 的
diff算法叫静态标记(PatchFlag),就是如果你的内容会变,我会给你一个flag,下次数据更新的时候我直接来对比你,我就不对比那些没有标记的了。 
- 更好的Typescript支持
- vue3 源码本身就是用 TypeScript 写的
- tree-shaking
- 编译阶段利用
ES6 Module判断哪些模块已经加载 - 判断那些模块和变量未被使用或者引用,进而删除对应代码
- setup
详解如下
setup 讲解
setup 函数是组合式 API 的核心功能,setup 是在组件实例创建之前执行的,也就是说组件还未完全创建,this 也还不存在。
setup 是 Vue3 组件的入口函数。
它接收两个参数:props 和 context,并且在组件实例创建之前运行。(如果不是语法糖写法,需要把定义的数据和方法给return出去)
- props 是从父组件传递过来的,具有响应式特性。
- context 是一个普通的 JavaScript 对象,包含三个属性:
- attrs:包含所有没有在 props 中声明的特性。
- slots:用于访问插槽内容。
- emit:用于触发事件。
<script> |
script setup
是 setup 的语法糖
所有在 <script setup> 中定义的变量和函数都会自动导出到模板中,无需手动返回。<script setup> 在编译阶段进行优化,性能比传统的 setup 函数更高。
自动解构 props并简化 emit 事件:在 <script setup> 中,组件的 props 会自动解构,无需显式使用 props 参数。使用 defineEmits 可以直接定义并使用 emit。
<template> |
生命周期 ⭐
| 生命周期 | 描述 | 生命周期 |
|---|---|---|
| beforeCreate | beforeCreate组件实例被创建之初 | 实例还未创建,通常用于插件开发中执行一些初始化任务 |
| created | created组件实例已经完全创建 | 组件初始化完毕,data和method可以使用,dom未创建(所以更新数据不会造成页面闪动),常用于数据初始化、事件监听、异步请求 |
| beforeMount | beforeMount组件挂载之前 | 未渲染、更新,dom未创建 |
| mounted | mounted组件挂载到实例上去之后 | 初始化结束,dom已创建,可用于获取访问数据和dom元素,如获取元素尺寸、绑定事件、设置定时器 |
| beforeUpdate | beforeUpdate组件数据发生变化,更新之前 | 更新前,可用于获取更新前各种状态 |
| updated | updated组件数据更新之后 | 更新后,所有状态已是最新 |
| beforeDestroy | beforeDestroy组件实例销毁之前 | 销毁前,data和method还可用,可用于一些定时器或订阅的取消 |
| destroyed | destroyed组件实例销毁之后 | 组件已销毁,数据与方法均不可用 |
| activated | keep-alive 缓存的组件激活时 | |
| deactivated | keep-alive 缓存的组件停用时调用 | |
| errorCaptured | 捕获一个来自子孙组件的错误时被调用 |
创建前后,挂载前后,更新前后,销毁前后,激活前后
父子组件生命周期
父beforeCreate -> 父created -> 父beforeMount ->
子beforeCreate -> 子created -> 子beforeMount -> 子mounted ->
父mounted->
父beforeUpdate->子beforeUpdate->子updated->父updated->
父beforeDestroy->子beforeDestroy->子destroyed->父destroyed
父 3 子 4,父挂载,父子子父,父子子父
实例挂载流程
new Vue的时候调用会调用_init方法(定义方法、事件、生命周期)- 定义
$set、$get、$delete、$watch等方法 - 定义
$on、$off、$emit、$off等事件 - 定义
_update、$forceUpdate、$destroy生命周期
- 定义
- 调用
$mount进行页面的挂载 - 挂载的时候主要是通过
mountComponent方法 - 定义
updateComponent更新函数 - 执行
render生成虚拟DOM _update将虚拟DOM生成真实DOM结构- 最后渲染到页面中
v-if 与 v-show 的区别
- 控制手段不同
v-if显示隐藏是将dom元素整个添加或删除v-show隐藏则是为该元素添加css--display:none,dom元素依旧还在 - 性能消耗
v-if有更高的切换消耗v-show有更高的初始渲染消耗 - 编译过程不同
v-if切换有一个局部编译/卸载的过程,切换过程会触发组件的生命周期钩子,合适地销毁和重建内部的事件监听器和子组件v-show只是简单的基于 css 切换,变换时不会触发组件的生命周期
v-if出现时触发组件的beforeCreate、create、beforeMount、mounted钩子,- 销毁时触发组件的
beforeDestory、destoryed方法
v-if 和 v-for
v-for优先级比v-if高
永远不要把 v-if 和 v-for 同时用在同一个元素上,带来性能方面的浪费(每次渲染都会先循环再进行条件判断)
// 套一个 template 给 v-if 先进行判断 |
- 如果条件出现在循环内部,可通过计算属性
computed提前过滤掉那些不需要显示的项
computed: { |
组件间通信 ⭐
- 父子组件通信
- 兄弟组件通信
- 祖孙与后代组件之间的通信
- 非关系组件间之间的通信
- 全局组件通信
整理vue中8种常规的通信方案
- 通过 props 传递
- 父传子,父组件给子组件设置字面量,子组件中使用defineProps()接收
<!-- Parent.vue -->
<template>
  <Child msg="message" />
</template>

<!-- Child.vue -->
<template>
  <div>
    {{ msg }}
  </div>
</template>

<script setup>
const props = defineProps({
  msg: {
    type: String,
    default: ''
  }
})
console.log(props.msg) // 在 js 里需要使用 props.xxx 的方式使用。在 html 中使用不需要 props
- 通过 emit 触发自定义事件
- 适用场景:子传父,子组件传递数据给父组件
- 子组件通过
emit触发自定义事件,emit第二个参数为传递的数值 - 父组件绑定监听器获取到子组件传递过来的参数
<!-- ChildComponent.vue -->
<script setup>
// 使用defineEmits定义可触发的事件 'update'
const emit = defineEmits(['update'])
// 当调用updateParent时,触发'update'事件,传递数据给父组件
const updateParent = () => {
  emit('update', 'Hello from ChildComponent')
}
</script>

<template>
  <!-- 监听点击事件,触发 updateParent -->
  <button @click="updateParent">Update Parent</button>
</template>
<!-- ParentComponent.vue -->
<template>
<!-- 监听子组件触发的'update'事件,并使用handleUpdate处理 -->
<ChildComponent @update="handleUpdate"/>
</template>
<script setup>
import ChildComponent from './ChildComponent.vue'
// 定义处理事件的方法
const handleUpdate = (message) => {
console.log(message) // 输出从子组件接收到的消息
}
</script>
- [父调子] 使用 expose / ref(父元素调用子元素自身事件)
- 子组件可以通过
expose暴露自身的方法和数据。 - 父组件通过
ref获取到子组件并调用其方法或访问数据。 - 使用 defineExpose 向外暴露指定的数据和方法
- 子组件 defineExpose({ message, changeMessage })
- 父组件 ref.value.changeMessage
- 举例:父元素滚动到底部,调用子元素加载更多方法
EventBus
- 插槽(父传子)
- $parent 或$root
- $attrs 与 listeners(Vue3 已移除)
祖孙传值 Provide 与 Inject
provide(属性名,属性值[可以是方法])// Parent.vue
<script setup>
const name = ref('姓名')
provide('msg', name)
provide('changeName', (value) => {
name.value = value
})
</script>
// Child.vue
<template>
<div>
<div>name: {{name}}</div>
<button @click="handleClick">修改</button>
</div>
</template>
<script setup>
import { inject } from 'vue'
const name = inject('name', 'hello') // 设置默认值设为 hello
const changeName = inject('changeName')
function handleClick() {
changeName('修改姓名')
name.value = '修改姓名'
}
</script>Pinia / Vuex 全局状态管理
双向数据绑定 v-model
理解 ViewModel
它的主要职责就是:
- 数据变化后更新视图
- 视图变化后更新数据
v-model 本质上是一个语法糖,可以看成是 value + input 方法的语法糖。可以通过model的prop属性和event事件来进行自定义。
<input v-model="sth" /> // 这一行等于下一行 |
Slot 插槽
通过插槽可以更好地复用组件和对其做定制化处理
就像项目中的 modal 弹窗组件,源文件中通过插槽暴露出可修改的位置
然后在不同的地方引入时,只需要在相应位置进行修改即可
<!-- 子组件 Child.vue --> |
方法修饰符
- 表单修饰符
- lazy 光标离开标签(失去焦点)时,才会将值赋予给
value,也就是在change事件之后再进行信息同步 - trim 自动过滤用户输入的首尾空格字符
- number 自动将用户的输入值转为数值类型,但如果这个值无法被
parseFloat解析,则会返回原来的值
- 事件修饰符
- stop 阻止事件冒泡 = event.stopPropagation
- prevent 阻止了事件默认行为,=
event.preventDefault - self 只当在
event.target是当前元素自身时触发处理函数- 注意修饰符顺序,用
v-on:click.prevent.self会阻止所有的点击,而v-on:click.self.prevent只会阻止对元素自身的点击
- 注意修饰符顺序,用
- once 事件只能触发一次,第二次就不会触发
- capture 使事件触发从包含这个元素的顶层开始往下触发
- passive 在移动端,当我们在监听元素滚动事件的时候,会一直触发
onscroll事件会让我们的网页变卡,因此我们使用这个修饰符的时候,相当于给onscroll事件整了一个.lazy修饰符 - native 让组件变成像
html内置标签那样监听根元素的原生事件,否则组件上使用v-on只会监听自定义事件
<my-component v-on:click.native="doSomething"></my-component> |
- 鼠标按键修饰符
- left 左键点击
- right 右键点击
- middle 中键点击
- 键值修饰符
- 普通键(enter、tab、delete、space、esc、up…)
- 系统修饰键(ctrl、alt、meta、shift…)
常用
- .stop:阻止事件冒泡
- .native:绑定原生事件
- .once:事件只触发一次
- .self :将事件绑定在自身身上,相当于阻止事件冒泡
- .prevent:阻止默认事件
- .caption:用于事件捕获
- .keyCode:监听特定键盘按下
- .right:右键
虚拟DOM
虚拟 DOM 是一层对真实DOM的抽象,以JavaScript 对象 (VNode 节点) 作为基础的树,用对象的属性来描述节点,最终可以通过一系列操作使这棵树映射到真实环境上
在Javascript对象中,虚拟DOM 表现为一个 Object对象。并且最少包含标签名 (tag)、属性 (attrs) 和子元素对象 (children) 三个属性
通过VNode,vue可以对这颗抽象树进行创建节点,删除节点以及修改节点的操作, 经过diff算法得出一些需要修改的最小单位,再更新视图,减少了dom操作,提高了性能
当你在一次操作时,需要更新10个DOM节点,浏览器没这么智能,收到第一个更新DOM请求后,并不知道后续还有9次更新操作,因此会马上执行流程,最终执行10次流程
而通过VNode,同样更新10个DOM节点,虚拟DOM不会立即操作DOM,而是将这10次更新的diff内容保存到本地的一个js对象中,最终将这个js对象一次性attach到DOM树上,避免大量的无谓计算(类似对dom元素的合并操作)
虚拟 DOM 最大的优势不止是 diff 算法,减少 JavaScript 操作真实 DOM 的带来的性能消耗。
虚拟 DOM 最大的优势在于抽象了原本的渲染过程,实现了跨平台的能力,而不仅仅局限于浏览器的 DOM,可以是安卓和 IOS 的原生组件,可以是近期很火热的小程序
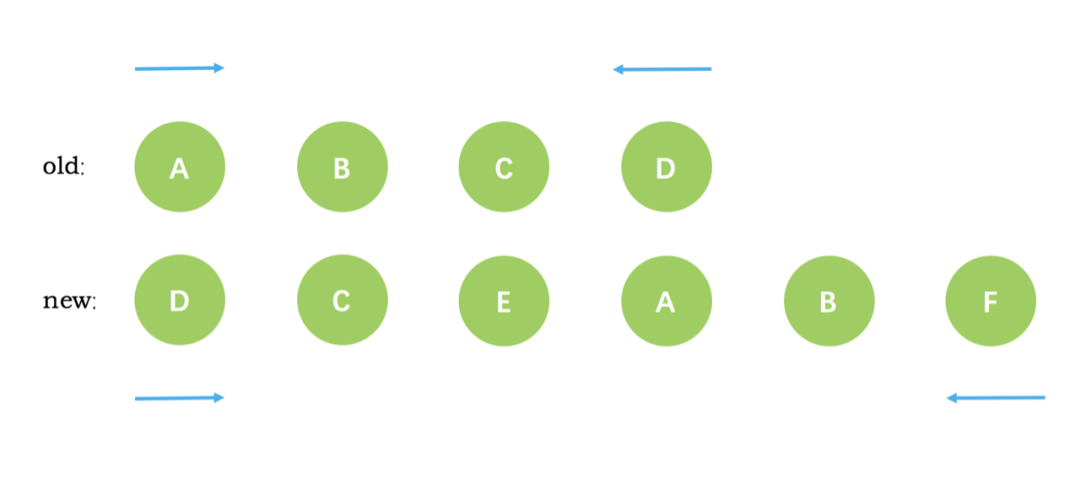
diff 算法
diff 算法是一种通过同层的树节点进行比较的高效算法
用于虚拟 dom 渲染成真实 dom 的新旧 VNode 节点比较
特点:比较只会在同层级进行,在过程中循环从两边向中间比较
diff整体策略为:深度优先,同层比较
- 比较只会在同层级进行, 不会跨层级比较
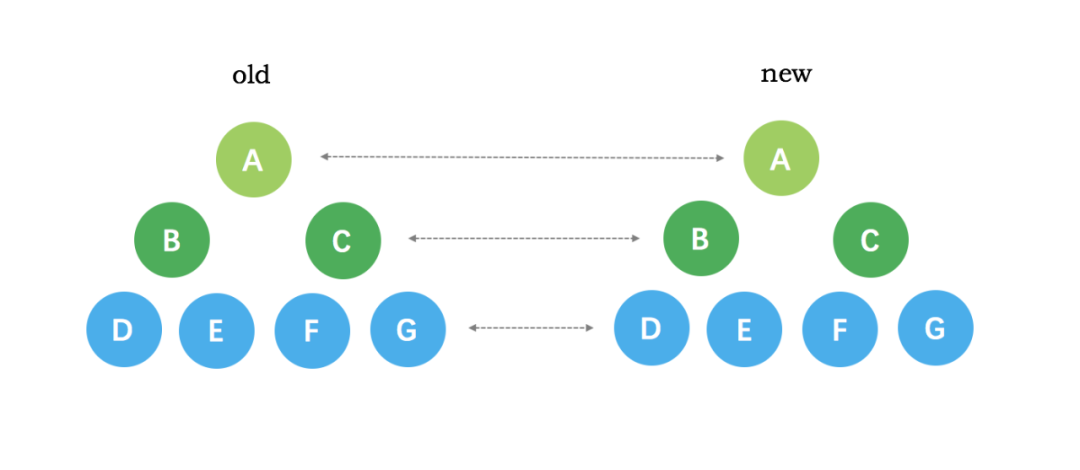
- 比较的过程中,循环从两边向中间收拢
hooks / mixin / utils 区别
Vue3 中 hooks 函数封装和使用
hooks 是什么
vue3 中的 hooks 就是函数的一种写法,就是将文件的一些单独功能的 js 代码进行抽离出来进行封装使用。
它的主要作用是 Vue3 借鉴了 React 的一种机制,用于在函数组件中共享状态逻辑和副作用,从而实现代码的可复用性。
注意:其实 hooks 和 vue2 中的 mixin 有点类似,但是相对 mixins 而言, hooks 更清楚复用功能代码的来源, 更清晰易懂。
hooks 的优点
hooks 作为独立逻辑的组件封装,其内部的属性、函数等和外部组件具有响应式依附的作用。
自定义 hook 的作用类似于 vue2 中的 mixin 技术,使用方便,易于上手。
使用 Vue3 的组合 API 封装的可复用,高内聚低耦合。
自定义 hook 需要满足的规范
- 具备可复用功能,才需要抽离为 hooks 独立文件
- 函数名/文件名以 use 开头,形如: useXX
- 引用时将响应式变量或者方法显式解构暴露出来;
const { nameRef, Fn } = useXX() |
hooks 和 utils 区别
utils 是通用的工具函数,而 hooks 是对 utils 的一种封装,用于在组件中共享状态逻辑和副作用。
相同点:通过 hooks 和 utils 函数封装, 可以实现组件间共享和复用,提高代码的可重用性和可维护性。
异同点:
- 表现形式不同: hooks 是在 utils 的基础上再包一层组件级别的东西(钩子函数等);utils 一般用于封装相应的逻辑函数,没有组件的东西
- 数据是否具有响应式: hooks 中如果涉及到 ref,reactive,computed 这些 api 的数据,是具有响应式的;而 utils 只是单纯提取公共方法就不具备响应式
- 作用范围不同: hooks 封装,可以将组件的状态和生命周期方法提取出来,并在多个组件之间共享和重用;utils 通常是指一些辅助函数或工具方法,用于实现一些常见的操作或提供特定功能
hooks 和 mixin 区别
相同点: hooks 和 mixin,都是常用代码逻辑抽离手段,方便进行代码复用;
hooks 是函数,mixin 是对象
mixins 缺点:
- 变量来源不明确(隐式传入),不利于阅读(mixin一多就太乱了,不知道哪个方法是哪个mixin带来的,因为都是直接引入个文件就能通过this访问到),使代码变得难以维护。
- 命名冲突:多个 mixins 的生命周期会融合到一起运行,但是同名属性、同名方法无法融合,可能会导致冲突。
- Vue3 自定义 Hooks 是组件下的函数作用域的,而 Vue2 时代的 Mixins 是组件下的全局作用域。
注:VUE3 提出的 Composition API 旨在解决这些问题。mixins 的缺点是 Composition API 背后的主要动因之一,Composition API 受到 React Hooks 的启发。
// hooks 代码 useCount.ts 函数示例: |
// Mixins 的代码 |
// Mixins 在组件中调用 |
可以看到,通过 mixin 混入的方法与变量,直接通过 this 就能获取,而无需在顶部显式声明,如果存在多个 mixin 与多个变量方法,会导致混乱与冲突。在实习项目中深有体会。
这两个示例展示了使用 Hooks 和 Mixins 的代码风格和组织方式的不同。Hooks 使用函数式的方式来定义逻辑和状态,而 Mixins 则是通过对象的方式进行组合和共享代码。
Vue3 自定义 Hooks 是组件下的函数作用域的,而 Vue2 时代的 Mixins 是组件下的全局作用域。全局作用域有时候是不可控的,就像 var 和 let 这些变量声明关键字一样,const 和 let 是 var 的修正。Composition Api 正是对 Vue2 时代 Option Api 高耦合和随处可见 this 的黑盒的修正,Vue3 自定义 Hooks 是一种进步。
watch 与 watchEffect
1、watch 是需要传入侦听的数据源,而 watchEffect 是自动收集数据源作为依赖。
2、watch 可以访问侦听状态变化前后的值,而 watchEffect 没有。
3、watch 只有在属性改变的时候执行(初始化时不执行),而 watchEffect 是先默认会执行一次,然后属性改变也会执行。
Vue 性能优化
总之就是减少 dom 开销,操作 dom 是很金贵的
- 减少组件数量:
尽量减少页面上的组件数量,尤其是那些频繁更新的数据。可以使用 Vue 的 Slot 或者 Fragment 来避免多余的组件包装。 - 使用
v-show和v-if:v-if在切换时会销毁和重建 DOM 元素,而v-show只是简单地切换元素的 CSSdisplay属性。根据具体场景选择v-if或v-show可以优化性能。 - 懒加载和代码拆分:
在大型应用中,可以使用异步组件和路由懒加载来实现代码拆分,从而减少初始下载量。 - 使用
key提高渲染性能:
在列表渲染中使用唯一的key属性,可以帮助 Vue 高效地更新 DOM。 - 事件监听器的清理:
确保组件销毁时清理未使用的事件处理器,以防止内存泄漏。 - 使用 computed 属性:
将复杂的计算逻辑放在computed属性中,而不是在模板内直接进行计算,这样可以减少计算次数。 - 使用 Vue 的缓存选项:
使用keep-alive组件可以缓存不需要频繁更新的组件,避免重复渲染。 - 缩小数据观察范围:
尽量缩小 Vue 观察的数据范围,避免不必要的数据绑定和监控。例如,如果你只需要监控一个对象的某个属性,而不是整个对象,可以单独使用属性。 - 避免深层次 data 嵌套:
尽量避免在 data 中使用深层次的嵌套结构,因为 Vue 会递归地遍历整个对象来添加响应式数据,这会影响性能。
其他
为什么data属性是一个函数而不是一个对象?
- 根实例对象
data可以是对象也可以是函数(根实例是单例),不会产生数据污染情况 - 组件实例对象
data必须为函数,目的是为了防止多个组件实例对象之间共用一个data,产生数据污染。采用函数的形式,initData时会将其作为工厂函数都会返回全新data对象
动态添加新的响应式属性
vue3是用过proxy实现数据响应式的,直接动态添加新属性仍可以实现数据响应式
vue2 若想实现数据与视图同步更新,可采取下面三种解决方案:
- Vue.set() // Vue3 已移除
- Object.assign()
- $forcecUpdated()
vue2中采用defineProperty来劫持整个对象,然后进行深度遍历所有属性,给**每个属性添加getter和setter,**实现响应式
vue3采用proxy重写了响应式系统,因为proxy可以对整个对象进行监听,所以不需要深度遍历
mvc、mvp、mvvm 架构模式
MVC = Model-View-Controller
MVP = Model-View-Presenter
MVVM = Model-View-ViewModel
这三个架构模式,都分别有三个不同的部件,都有相同的 Model 层和 View 层。
Model 为模型层,主要管理业务模型的数据和行为;
View 为展示层,其职责就是管理用户界面。
三个目的都是为了解耦 Model 和 View,主要不同点就在于三者实现解耦的方案不同。
Controller、Presenter、ViewModel,对应三种解耦方案,三种与 M 和 V 的连接方式
MVC(模型-视图-控制器)
- 定义: MVC将应用程序分为三个主要组成部分:模型(Model)、视图(View)和控制器(Controller)。
- Model 负责管理应用程序的数据和逻辑;
- View 是用户界面;
- Controller 负责接收用户输入并调用模型和视图完成请求的处理。
- 使用场景: Web应用程序开发,如Ruby on Rails、Django等框架。
- 例子: 在一个Web应用程序中,用户请求一个页面,控制器决定使用哪个模型来处理请求,然后选择一个视图来显示模型的数据。
- 本质区别: MVC强调的是动作的分离,控制器作为模型和视图之间的中介,处理所有的用户交互。
MVP(模型-视图-呈现器)
- 定义: MVP模式将应用分为三个部分:模型(Model)、视图(View)和呈现器(Presenter)。
- Model 管理数据;(⚠ 不包含业务逻辑)
- View 负责显示界面;
- Presenter 作为模型和视图之间的桥梁,处理所有的业务逻辑。
- 使用场景: 桌面应用程序和一些现代的Web应用框架,如GWT(Google Web Toolkit)。
- 例子: 在一个桌面应用中,用户的点击事件由呈现器接收,呈现器然后从模型获取数据并决定如何在视图上展示这些数据。
- 本质区别: MVP中,视图与模型不直接交互,所有交互都通过呈现器完成,这使得视图和模型的耦合度更低。
MVVM(模型-视图-视图模型)
- 定义: MVVM模式包括模型(Model)、视图(View)和视图模型(ViewModel)。
- Model 管理数据和业务逻辑;
- View 是用户界面;
- ViewModel 是一个抽象的视图,它持有模型并暴露数据和命令,使得视图可以使用数据绑定。
- 使用场景: 主要用于构建客户端应用程序,如使用WPF(Windows Presentation Foundation)、Silverlight和AngularJS。
- 例子: 在使用WPF技术的应用程序中,视图模型包含了用户界面所需的所有数据和命令,视图通过数据绑定来显示这些信息,无需编写专门的代码来更新界面。
- 本质区别: MVVM的关键在于数据绑定,这允许视图和视图模型之间的自动同步,从而减少了必需的胶水代码,使开发更加简洁。
总结来说,这三种模式的本质区别在于它们各自对于应用程序中不同角色的处理和分离方式。MVC侧重于分离控制逻辑,MVP将视图和模型通过呈现器连接,而MVVM则利用数据绑定来减少视图和逻辑之间的直接交互。选择哪一种模式主要取决于应用的需求、技术栈和开发团队的偏好。
TypeScript
interface、type ⭐
interface(接口)用于定义对象类型,描述对象形状
type(类型别名),类型别名只是给类型起一个新名字。它并不是一个类型,只是一个别名而已。
相同点
都可以定义一个对象或函数、允许继承
interface 用 extand 继承
type 用 & [交叉类型] 继承
不同点
接口只能为对象指定类型,类型别名可以为任意类型指定别名
interface 可以合并重复的声明为一个大的声明
type 可以声明基本类型、联合类型、交叉类型、元组
一般要用类的 extends 或 implements 时,用 interface。
一般使用组合或者交叉类型的时候,用 type。
Pick、Omit
Pick 和 Omit 都是 TypeScript 中的实用类型。
Pick 类型可以从一个已有的类型中挑选出一些子属性,创建一个新的子类型。
比如 Person 类包含 name、age、address。
可以使用 Pick 来创建一个只包含 name 和 age 属性的新类型:
type PersonSummary = Pick<Person, 'name' | 'age'>; |
Omit(排除) 与 Pick 相反,Omit 可以帮助我们从一个已有的类型中剔除一些子属性,创建一个新的子类型。可以使用 Omit 来创建一个不包含 address 属性的新类型:
type PersonWithoutAddress = Omit<Person, 'address'>; |
extends 与 implements
extends用于类的继承,子类继承父类的所有属性和方法。implements用于接口实现,类必须实现接口中声明的所有属性和方法。(用于强制类遵循某个接口的结构)- 类可以实现多个接口,但只能继承自一个父类。
数据类型
比JavaScript多了几种类型
- tuple(元组类型)
- enum(枚举类型)
- any(任意类型)
- void 类型
- never 类型
数组类型声明
:number[]
Array
推荐第一种
方式一:元素类型后面接上 []
let arr:string[] = ['12', '23']; |
方式二:使用数组泛型,Array<元素类型>:
let arr:Array<number> = [1, 2]; |
tuple
元组类型,允许表示一个已知元素数量和类型的数组,各元素的类型不必相同
let tupleArr:[number, string, boolean]; |
enum 类型
对 JavaScript 标准数据类型的一个补充,使用枚举类型可以为一组数值赋予友好的名字
例如表示星期的 SUNDAY、MONDAY、TUESDAY、WEDNESDAY、THURSDAY、FRIDAY、SATURDAY 就可以看成是一个枚举
enum Color {Red, Green, Blue} |
联合类型
(number | string)[]
number | string[]
类型别名 type (简化书写)
type CustomArray = (number | string)[]
let arr1: CustomArray=[1,’a’,2,’b’]
let arr2: CustomArray=[1,’a’,2,’b’,3]
函数类型(给参数和返回值添加类型)[?可选参数需要放在所有参数的最后面,例num?: number]
function add(num1:number,num2:number):number{
return num1+num2
}
也可以
const add = (num1:number,num2:number):number => {
return num1+num2
}
对象类型
let person:{name:string;sayHi():void}={……}
或
let person:{name:string;sayHi:()=>void}={……}
接口
(描述对象的类型,达到复用的目的)[接口只能为对象指定类型,类型别名可以为任意类型指定别名]
interface IPerson{
name:string
sayHi():void
}
let person: IPerson ={……}
接口的继承
interface Point3D extends Point2D{z:number}
元组(确切标记处元素的 个数 + 类型)
let position:[number,number] = [1,1]
类型推断(编辑器功能)
类型断言
const a = XXX as HTMLElement
也可以使用<>
const a =
字面量类型(配合联合类型,用于明确的表示一组可选值列表)
字符串与数字都可以作为一个类型
function changeDirection(direction:’up’ | ‘down’ | ‘left’ | ‘right’){……}
枚举(类似字面量类型+联合类型)[注意枚举值需要大写]
enum Direction {Up,Down,Left,Right}
function changeDirection(direction:Direction){……}
访问时通过’.’操作符:Direction.Up
typeof 类型上下文
相当于ts帮你推断上文变量类型
class 类
extends 继承父类
implements 实现接口
可见性
readonly 只读属性
类型兼容性
接口兼容性、函数兼容性
交叉类型 & (类似于接口继承)
interface A……
interface B……
type C = A & B
泛型
泛型允许我们编写代码时,使用一些以后才指定的类型(可以不预先定义好具体的类型,而在使用的时候再指定类型)【比如一个函数既可以给number用,也可以给string用,就可以用 T 来指代】
(保证类型安全的同时,让函数等与多种类型一起工作,从而实现复用)
例:假设我们用一个函数,它可接受一个 number 参数并返回一个number 参数:
function returnItem (para: number): number { |
如果我们打算接受一个 string 类型,然后再返回 string类型,则如下写法:
function returnItem (para: string): string { |
上述两种编写方式,存在一个最明显的问题在于,代码重复度比较高
虽然可以使用 any类型去替代,但这也并不是很好的方案,因为我们的目的是接收什么类型的参数返回什么类型的参数,即在运行时传入参数我们才能确定类型
这种情况就可以使用泛型,如下所示:
function returnItem<T>(para: T): T { |
function id
return value
}
泛型约束
function id
return value
}
其余说明
类型声明文件 .d.ts 用于给第三方库的代码(JavaScript 代码)提供类型
let notSure: any = 4;
let list: any[] = [1, true, “free”];
数组
let list1: number[] = [1, 2, 3];
let list2: Array
元组
let x: [string, number];
x = [‘hello’, 10]; // OK
x = [10, ‘hello’]; // Error
枚举
enum Color {Red, Green, Blue}
let c: Color = Color.Green;
联合类型 与 类型断言
/* 定义一个函数得到一个字符串或数值数据的长度 */
function getLength(x: number | string) {
// 两者都可 =>
if ((
return (x as string).length
} else {
return x.toString().length
}
}
console.log(getLength(‘abcd’), getLength(1234))
interface IPerson {
// 只读属性
readonly id: number
name: string
age: number
// ?可选属性
sex?: string
}
interface SearchFunc {
// 参数的类型 与 返回值的类型
(source: string, subString: string): boolean
}
const mySearch: SearchFunc = function (source: string, sub: string): boolean {
return source.search(sub) > -1
}
类类型: 实现接口
\1. 一个类可以实现多个接口
interface Alarm {alert(): any;}
interface Light { lightOn(): void;}
class Car implements Alarm, Light {
alert() {
console.log(‘Car alert’);
}
lightOn() {
console.log(‘Car light on’);
}
lightOff() {
console.log(‘Car light off’);
}
}
\2. 一个接口可以继承多个接口
interface LightableAlarm extends Alarm, Light {}
class Student {
// 声明属性
fullName: string;
// 构造方法
constructor(public firstName: string,
public middleInitial: string,
public lastName: string) {
this.fullName = firstName + “ “ + middleInitial + “ “ + lastName;
}
// 一般方法
greet (): string {
return ‘Hello ‘ + this.fullName
}
}
// 创建类的实例
const user = new Student(“Jane”, “M.”, “User”);
// 调用实例的方法
console.log(user.greet())
我们在引用任何一个类成员的时候都用了 this。 它表示我们访问的是类的成员。
类的继承
class Animal {
run (distance: number) {
console.log(Animal run ${distance}m)
}
}
class Dog extends Animal {
cry () {
console.log(‘wang! wang!’)
}
}
const dog = new Dog()
dog.cry()
dog.run(100) // 可以调用从父中继承得到的方法
在 TypeScript 里,成员都默认为 public
你可以使用 readonly 关键字将属性设置为只读的。 只读属性必须在声明时或构造函数里被初始化。
参数属性
在上面的例子中,我们必须在 Person 类里定义一个只读成员 name 和一个参数为 name 的构造函数,并且立刻将 name 的值赋给 this.name,这种情况经常会遇到。 参数属性可以方便地让我们在一个地方定义并初始化一个成员。 下面的例子是对之前 Person 类的修改版,使用了参数属性:
class Person2 {
constructor(readonly name: string){
}
}
const p = new Person2(‘jack’)
console.log(p.name)
作用同下:
class Person {
readonly name: string = ‘abc’
constructor(name: string) {
this.name = name
}
}
注意看我们是如何舍弃参数 name,仅在构造函数里使用 readonly name: string 参数来创建和初始化 name 成员。
我们把声明和赋值合并至一处。
函数:默认值 与 可选值
function buildName(firstName: string=’A’, lastName?: string): string { … }
优化方案
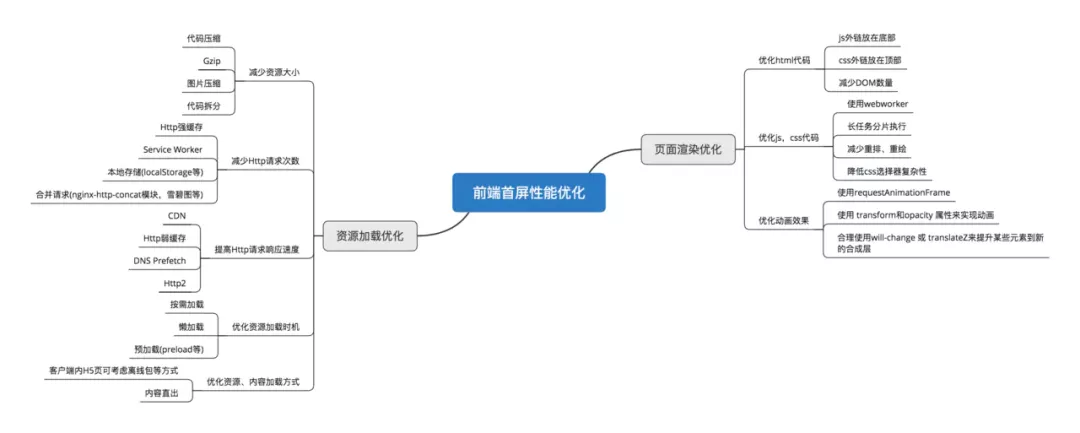
首屏加载优化
首先获取首屏事件方式
- 监听 DOMContentLoaded
- performance.timing
// 方案一: |
资源加载 + 页面渲染
首屏加载优化可以分成两大部分:
- 资源加载优化
- 页面渲染优化
资源加载优化
- 资源
- 资源体积压缩(Gzip 代码 / Webp图片)
- 减小入口文件体积 —— 如路由动态加载
- 框架按需引入,避免全量引入无法 tree-shaking 导致包体积过大
- 多次引用文件抽离到公共依赖,避免组件重复打包
- 加载(http请求)
- 提高请求速度
- http2 多路复用
- CDN 边缘分发网络
- dns-prefetch 预加载
- 减少请求数量
- http 缓存(协商缓存/强缓存,设置
Cache-Control,Last-Modified,Etag等响应头) - Service Worker 离线缓存
- 按需加载,懒加载
- 合并请求【雪碧图】
- http 缓存(协商缓存/强缓存,设置
页面渲染优化
- 操作 DOM:减少/合并对 DOM 的操作,减少重排重绘
- 提早 CSS:尽早尽快加载 CSS,避免阻塞 DOM 树/渲染树渲染
- 异步 JS:使用 async/defer,避免阻塞页面解析 + 渲染
- CSS 动画效果 raf / transform 原生
- JS 使用事件委托 (利用事件冒泡,监听ul,判断 e.target.nodeName === ‘LI’)
- SSR 服务端渲染(直接发送脱水后完整的html)
- 在传统的客户端渲染(Client-Side Rendering, CSR)模式下,用户访问页面时,浏览器首先需要下载 HTML 文件、CSS、JavaScript 等资源。JavaScript 下载完成后,才会执行渲染逻辑并生成实际的页面内容。这一过程中,用户可能会看到“白屏”(空白页面),直到 JavaScript 代码完成执行和页面渲染。
- 而在服务端渲染的模式下,服务器直接生成已经渲染好的 HTML 页面,并将其发送给用户。这样,当浏览器接收到 HTML 时,就已经包含了页面的完整内容,避免了白屏现象,用户可以立即看到页面的内容,而无需等待 JavaScript 执行完成。
- 在 CSR 中,页面的内容生成依赖于 JavaScript 文件的加载和执行。如果用户的网络连接较慢或者文件过大,下载这些 JavaScript 文件可能会花费较长时间,从而延迟页面的渲染和显示。
- SSR 则不同,因为服务器已经在用户请求之前完成了页面的渲染,并且生成的 HTML 文件相对较小,传输和处理速度更快。这在网络条件不佳时尤为重要,SSR 可以显著降低首屏加载时间。
优化详解
避免 css 阻塞
css 影响 renderTree 的构建,会阻塞页面的渲染,因此应该尽早(将 CSS 放在 head 标签里)和尽快(启用 CDN 实现静态资源加载速度的优化)的将css资源加载
- css 加载不会阻塞 DOM 树的解析
- css 加载会阻塞 DOM 树的渲染(Render Tree是依赖于DOM Tree和CSSOM Tree的,所以必须等待到CSSOM Tree构建完成后,才能开始渲染)
- css 加载会阻塞后面 js 语句的执行(因为js可能会操作之前的Dom节点和css样式)
避免 js 阻塞
js可以修改CSSOM和DOM,因此 js 会阻塞页面的解析和渲染,并且会等待 css 资源的加载。也就是说 js 会抢走渲染引擎的控制权。所以我们需要给 js 资源添加 defer 或者 async,延迟js脚本的执行。
减少重绘和回流
- 将多次修改存储到一个变量中,再对某个元素进行统一修改
- 避免多次修改单一样式,使用类名去合并样式,再对 classList 进行类名操作
- 【离档操作】通过设置元素属性
display: none,将其从页面上去掉,然后再进行后续操作,这些后续操作也不会触发回流与重绘
缩小 webpack 的 loader 匹配范围
- 通过 test、include、exclude 三个配置项来缩小 loader 的处理范围
- 推荐include
- include: path.resolve(__dirname, “./src”),
使用正则表达式 RegExp
正则表达式可以在一行代码中完成多个条件的检查,而无需编写多重循环或条件语句。例如,在上面的示例中,使用正则表达式来检查文本是否包含任意关键字相比于每个关键字的循环检查,代码更简洁且执行速度更快。
当模式很简单且输入字符串很大时:简单的正则表达式(不涉及回溯的模式)在大型字符串上的效率很高,因为它们可以在一个扫描过程中完成任务。
谨慎使用正则表达式:模式变得复杂,尤其是包含了像反向引用这样需要大量回溯的模式时,正则表达式可能会变得非常慢。此外,对于非常大的字符串,即使是简单的模式也可能导致性能问题。在这些情况下,可能需要寻找其他解决方案,或者优化正则表达式以减少回溯。
查找表
基于函数的迭代 forEach 比一般的循环要慢,如果对运行速度要求很严格,不要使用
if-else switch,条件数量越大,越倾向于使用 switch
在判断条件多时,可以使用查找表来代替if-else switch,速度更快
const results = [result0,result1,result2,...,result9,result10,result11] |
使用 requestAnimationFrame 来实现视觉变化
requestAnimationFrame 会在浏览器每次重绘时调用,并且可以根据设备的帧率自动调整调用的频率。
let position = 0; |
大多数设备屏幕刷新率为 60 次/秒,也就是说每一帧的平均时间为 16.66 毫秒。在使用 JavaScript 实现动画效果的时候,最好的情况就是每次代码都是在帧的开头开始执行。而保证 JavaScript 在帧开始时运行的唯一方式是使用 requestAnimationFrame。
如果采取 setTimeout 或 setInterval 来实现动画的话,回调函数将在帧中的某个时点运行,可能刚好在末尾,而这可能经常会使我们丢失帧,导致卡顿。
总结:
节能: 当页面不在当前标签页时,requestAnimationFrame 会暂停动画执行,避免无意义的资源消耗。
帧同步: requestAnimationFrame 自动根据屏幕刷新率调整执行频率,通常每秒 60 帧 (60 FPS)。
流畅性: 使用 requestAnimationFrame 的动画通常更加流畅,因为它的执行时机会与浏览器的渲染周期同步。
Vue 性能优化
- v-for 添加 key
- 路由动态加载
- 第三方插件按需引入
- 合理使用 computed 和 watch
- v-for 的同时避免使用 v-if
- destory 时销毁事件:比如addEventListener添加的事件、setTimeout、setInterval、bus.$on绑定的监听事件等
SEO 优化
- 语义化元素:如 h1、h2、p 等,有助于搜索引擎理解网页结构和内容。
- strong、em 标签
<b>和<strong>标签都是加粗文字的标签,其二者的区别就在于:<b>是为了加粗而加粗的,<strong>是为了强调而加粗的。
同样斜体标签<i>和<em>也有着相同的区别,<em>有强调效果。
推荐使用<strong> <em>,而不是<b> <i>等,单纯修改加粗等样式可以用css实现。
- 优化网页 title 和 Meta 标签,确保每个页面都有独特、相关的标题和Meta描述,包含关键词。
- logo 使用 a 标签加背景图
- img 图片标签的
alt属性是图片的替换文字。alt属性可以帮助爬虫快速理解图片的具体内容 - 网站性能会影响到网站的SEO排名
- SEO的禁忌之一就是用JS输出重要的内容。爬虫不会读取JS格式的内容,所以重要的内容必须是HTML格式,这也就是为什么现在流行的spa框架都不利于seo的原因之一
- 不使用iFrame。因为搜索引擎不会抓取iframe内的内容,所以重要内容绝对不能放在iframe中;
- 外链:在别的网站导入自己网站的链接。通过外链提升网站权重,提高网站流量。
- 301 重定向(集中域名权重)
- 集中域名权重,301 网址跳转其实是对域名权重进行转移,比如
www.juejin.cn重定向到juejin.cn,其实是把www.juejin.cn的权重转移到了juejin.cn,从而增加juejin.cn域名的权重;
- HTTPS站点比HTTP站点,能获得更好的排名。
- 使用服务端渲染
功能实现
跨域
定义
https://www.example.com:8080/path/resource.html?page=1&sort=desc#header |
在上述示例中:
● 协议 为HTTPS
● 主机名 为www.example.com
● 端口号 为8080
● 路径为 /path/resource.html
● 查询参数为 page=1&sort=desc
● 锚点为 header
跨域,指的是请求URL中 [协议、主机名、端口号] 三者中任意一个部分不相同。
原因
受限于浏览器的同源策略。(同源:域名、协议和端口号均相同)
所谓同源策略,其实是浏览器的一种安全机制,用于限制一个网页中的网络请求仅能够访问来自同一源的资源,主要目的是防止恶意网站通过脚本窃取其他网站的敏感数据,保障用户的隐私和安全。
例:当浏览器端的脚本(js文件)访问了其他域的网络资源时,就会出现跨域问题。
跨域请求是否真正发送到服务器?(请求发了,也受到了,但被浏览器拦截了)
这里很容易搞混,既然跨域了,那发送的请求应该会被浏览器给砍掉,不会到达服务器端,实则不然。跨域是可以正常发请求的,服务器端能够收到请求并且正确返回结果,只是被浏览器拦截了。
要永远记住一个原则:同源策略只存在浏览器端,服务器是没有跨域问题的,甚至用
postman等工具也不会出现跨域问题。
解决
- 开发环境:直接通过设置代理,转发请求
- 生产环境:
- nginx 代理请求转发(前端请求同源的nginx,由nginx去请求后端服务器,再把信息传回前端)
- JSONP,利用
<script>标签没有跨域限制,只支持GET请求。<script>
function callback(data) {
console.log(data); // 处理跨域获取的数据
}
</script>
<script src="http://example.com/api?callback=callback"></script> - WebSocket
- WebSockets 提供了一个双向通信渠道,它不受同源策略的限制,因此可以用来进行跨域通信。前端通过WebSocket连接到服务器,然后通过WebSocket发送和接收数据。
var socket = new WebSocket('ws://example.com/socket'); socket.onmessage = function(event) { var data = event.data; // 处理数据 };- 使用 CORS 跨域资源共享,服务器通过设置响应头来告诉浏览器允许的源、方法等信息,从而使得浏览器允许跨域请求。
## RESTful API
https://restfulapi.cn/
### 是什么
RESTful API 是一种**面向“资源”开发**的接口,是一种设计的风格
**根据「url 名词」和「http 动词」来操作服务器资源**
用 URL 定位资源,**url中尽量使用名词**,restful也可以称为“面向资源编程”
用 HTTP 动词(GET、POST、DELETE、PUT、PATCH)描述操作。
- GET(SELECT):【获取数据】从服务器取出资源(一项或多项)。
- POST(CREATE):【创建数据】在服务器新建一个资源。
- PUT(UPDATE):【修改全部数据】在服务器更新资源(客户端提供完整资源数据)。
- PATCH(UPDATE):【修改部分数据】在服务器更新资源(客户端提供需要修改的资源数据)。
- DELETE(DELETE):【删除数据】从服务器删除资源。
可以把RESTful API理解为**资源型接口**(比较纯粹,一个接口只返回一种索取的数据,完成一个列表渲染可能需要向多个接口请求资源),而以往我们所请求后端的接口是**消费型接口**(相当于给你一大段json,你所要的信息都在里面,自己拆分字段以获取信息,比如B站请求歌曲数据时返回的大段数据)。
### RESTful API 请求设计
**同一个接口地址,但通过不同的方式请求,返回不同的数据**
请求 = 动词 + 宾语
GET /zoos:列出所有动物园
POST /zoos:新建一个动物园
GET /zoos/ID:获取某个指定动物园的信息
PUT /zoos/ID:更新某个指定动物园的信息(提供该动物园的全部信息)
PATCH /zoos/ID:更新某个指定动物园的信息(提供该动物园的部分信息)
DELETE /zoos/ID:删除某个动物园
GET /zoos/ID/animals:列出某个指定动物园的所有动物
DELETE /zoos/ID/animals/ID:删除某个指定动物园的指定动物
宾语 URL 应该全部使用**名词复数**,可以有例外,比如搜索可以使用更加直观的 search 。 |
封装
目的:统一设置
- 请求基地址
- 携带 token
- 超时时间
- 设置请求头
- 错误处理
封装的同时,你需要和 后端协商好一些约定,请求头,状态码,请求超时时间…….
设置接口请求前缀:根据开发、测试、生产环境的不同,前缀需要加以区分
请求头 : 来实现一些具体的业务,必须携带一些参数才可以请求(例如:会员业务)
状态码: 根据接口返回的不同status , 来执行不同的业务,这块需要和后端约定好
请求方法:根据get、post等方法进行一个再次封装,使用起来更为方便
请求拦截器: 根据请求的请求头设定,来决定哪些请求可以访问
响应拦截器: 这块就是根据 后端`返回来的状态码判定执行不同业务
V8 引擎原理
V8引擎原理
JavaScript 源代码
↓ 经过 Parse 解析器
AST 抽象语法树(可被序列化为 JSON 格式)
↓ 经过 Ignition 解释器
ByteCode 字节码(二进制文件,有可移植性,能进行性能优化)
- Blink(浏览器内核)将源码交给V8引擎,Stream获取到源码并且进行编码转换
- Scanner会进行词法分析(lexical analysis),词法分析会将代码转换成tokens
- 接下来tokens会被转换成AST树,经过Parser和PreParser
- Parser就是直接将tokens转成AST树架构
- PreParser称之为预解析,为什么需要预解析呢?
- 这是因为并不是所有的JavaScript代码,在一开始时就会被执行.那么对所有的JavaScript代码进行解析,必然会影响网页的运行效率
- 所以V8引擎就实现了Lazy Parsing(延迟解析)的方案,它的作用是将不必要的函数进行预解析,也就是只解析暂时需要的内容,而对函数的全量解析是在函数被调用时才会进行
- 比如我们在函数outer内部定义了另外一个函数inner,那么inner函数就会进行预解析
- 生成AST树后,会被Ignition转成字节码(bytecode),之后的过程就是代码的执行。
服务端渲染
- 在传统的客户端渲染(Client-Side Rendering, CSR)模式下,用户访问页面时,浏览器首先需要下载 HTML 文件、CSS、JavaScript 等资源。JavaScript 下载完成后,才会执行渲染逻辑并生成实际的页面内容。这一过程中,用户可能会看到“白屏”(空白页面),直到 JavaScript 代码完成执行和页面渲染。
- 而在服务端渲染的模式下,服务器直接生成已经渲染好的 HTML 页面,并将其发送给用户。这样,当浏览器接收到 HTML 时,就已经包含了页面的完整内容,避免了白屏现象,用户可以立即看到页面的内容,而无需等待 JavaScript 执行完成。
- 在 CSR 中,页面的内容生成依赖于 JavaScript 文件的加载和执行。如果用户的网络连接较慢或者文件过大,下载这些 JavaScript 文件可能会花费较长时间,从而延迟页面的渲染和显示。
- SSR 则不同,因为服务器已经在用户请求之前完成了页面的渲染,并且生成的 HTML 文件相对较小,传输和处理速度更快。这在网络条件不佳时尤为重要,SSR 可以显著降低首屏加载时间。
服务端渲染(SSR)不仅涉及到HTML和CSS的渲染,它也包括了JavaScript的执行。在服务端渲染的过程中,**服务器会执行应用的JavaScript代码,以生成动态的HTML内容。**这意味着,服务器在发送给客户端的HTML中已经包含了应用的初始状态,包括预渲染的页面结构、样式以及一些动态数据。当这些HTML到达浏览器时,用户可以立即看到渲染好的页面,而不需要等待JavaScript文件下载并执行。
服务端渲染的主要优点包括更快的首屏加载时间和更好的搜索引擎优化(SEO),因为搜索引擎爬虫能够直接抓取和索引渲染好的HTML内容。然而,服务端渲染也需要服务器进行更多的计算工作,这可能会对服务器性能造成影响。
总的来说,服务端渲染是一种既包含HTML和CSS,也包含JavaScript执行的渲染方式,它能提供更快的页面加载速度和更好的SEO,但同时也对服务器性能有一定的要求。
名词解释:大/微前端、低代码、前端工程化
大前端
跨平台应用开发
微前端
将微服务的理念用于浏览器端,将Web应用由单一的单体应用转变为多个小型前端应用聚合为一的应用。
微前端主要采用的是组合式应用路由方案,该方案的核心是“主从,即包括一个基座(MainApp)应用和若干个微(MicroApp)应用,基座应用大多数是一个前端SPA项目,主要负责应用注册,路由映射,消息下发等,而微应用是独立前端项目,这些项目不限于采用React,Vue,Angular或者JQuery开发,每个微应用注册到基座应用中,由基座进行管理,但是如果脱离基座也是可以单独访问。
低代码
- 低代码开发平台本身也是一种软件,它为开发者提供了一个创建应用软件的开发环境。
- 低代码开发平台提供的是更高维和易用的可视化IDE。大多数情况下,开发者并不需要使用传统的手写代码方式进行编程,而是可以通过图形化拖拽、参数配置等更高效的方式完成开发工作。
能够实现业务应用的快速交付、降低业务应用的开发成本
前端工程化
前端工程化是一个整体,从前端开始写代码 –> 如何构建–> 如何发布测试–> 如何上线–>上线后的应用状态如何监控等,这一套的流程我们把他叫做【前端工程化】。
上拉加载,下拉刷新
// 触底 上拉加载 |
下拉刷新
- 监听原生
touchstart事件,记录其初始位置的值,e.touches[0].pageY; - 监听原生
touchmove事件,记录并计算当前滑动的位置值与初始位置值的差值,大于0表示向下拉动,并借助CSS3的translateY属性使元素跟随手势向下滑动对应的差值,同时也应设置一个允许滑动的最大值; - 监听原生
touchend事件,若此时元素滑动达到最大值,则触发callback,同时将translateY重设为0,元素回到初始位置
- 监听原生
document.addEventListener('DOMContentLoaded', function () { var startY, endY; var content = document.getElementById('content'); // 监听触摸开始事件 content.addEventListener('touchstart', function (e) { startY = e.touches[0].clientY; // 记录开始触摸的Y坐标 }, false); // 监听触摸结束事件 content.addEventListener('touchend', function (e) { endY = e.changedTouches[0].clientY; // 记录结束触摸的Y坐标 // 检查是否是下拉动作 if (endY - startY > 50) { // 自定义下拉距离阈值 refreshContent(); // 调用刷新内容的函数 } }, false); // 定义刷新内容的函数 function refreshContent() { // 这里可以执行AJAX请求来获取新的内容 // 为了演示,我们只是简单地更新了内容 content.innerHTML = '<p>内容已更新 at ' + new Date().toLocaleTimeString() + '</p>'; } });
第三方库:better-scroll
## 虚拟列表
初始化固定高度,计算渲染数量,滚动时根据可视区索引更新渲染区与缓存buffer区数据,占位处理处理滚动
1. **初始化**:设定一个容器(通常是一个`div`),用于显示列表可视部分,设定好它的高度和宽度,这个容器的**高度通常是固定的**,用以限制同时显示在屏幕上的项目数量。
2. **渲染可视项**:根据容器的高度和每个列表项的预估高度,计算出可视区域内大约能**容纳多少个列表项**。然后,渲染这些列表项到DOM中。这些列表项的数据是从整个列表数据中抽取的一部分,基于当前的滚动位置。
3. **滚动监听与数据更新**:给容器添加滚动事件监听器。当用户滚动时,计算当前滚动位置对应的列表数据的**索引范围**,并据此更新容器中的列表项,**移除**不再可视的项目,并**渲染新进入可视区域**的项目。**设置buffer区**:为了使页面平滑滚动,我们还需要在可见区域的上方和下方渲染额外的项目,在滚动时给予一些缓冲
4. **优化性能**:为了避免滚动时的性能问题,可以使用技术如节流(throttle)或防抖(debounce)来限制事件处理函数的执行频率。此外,使用`requestAnimationFrame`来平滑渲染过程也是一个好方法。
5. **占位处理**:为了保持滚动条的一致性和准确性,需要在容器内部使用一个**足够高度的占位元素**,以模拟整个列表的高度。当用户滚动时,实际渲染的列表项位于这个占位元素内的适当位置,从而使滚动行为与全量数据的滚动相匹配。
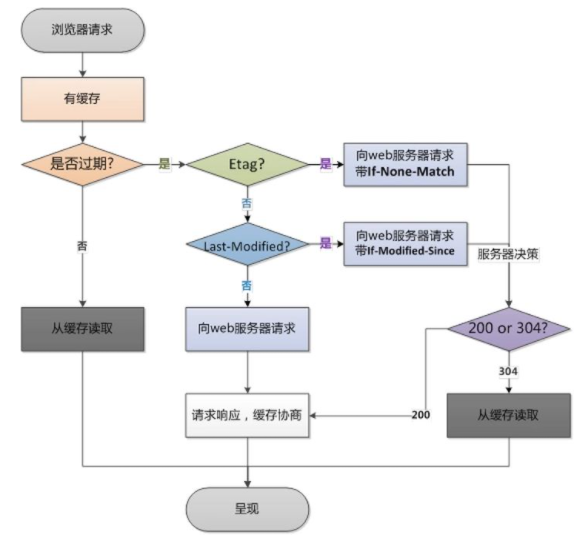
## 浏览器缓存
- **提升性能和加快加载速度**
- 减小了服务器的压力,**减少网络流量和节省带宽**
- **离线访问支持**
### 缓存资源的位置
内存(`from memory cache`)
几乎所有的网络请求都会根据相关的策略被浏览器自动放入`memory cache`中,关闭tab标签页时,内存中的缓存会释放掉。
硬盘(`from disk cache`)
根据HTTP Hearder中的字段判断哪些资源需要缓存,哪些资源可以不请求直接使用,哪些资源过期了需要重新请求。
### 缓存类型
#### 强制缓存
**强缓存**(Cache-Control 和 Expires):强缓存是通过在服务器响应头中设置相关的缓存策略信息,使**浏览器**在接收到响应后直接从缓存中获取资源,而无需与服务器进行通信,**强缓存不会向服务器发起请求**。**(一般是时间相关)**
1. Cache-Control:该响应头字段指定了资源的**缓存策略**。常见的值包括:
- `max-age=<seconds>`:指定资源在缓存中的有效时间,单位为秒。例如,`max-age=3600`表示资源在缓存中有效一小时。
- `no-cache`:表示每次请求都要与服务器进行验证,不能直接使用缓存。
- `no-store`:表示不缓存任何请求或响应的内容。
1. Expires:该响应头字段指定了资源的**过期时间**,是一个具体的日期时间。**new Date ("2022-7-30 23:59:59");**
#### 协商缓存
**协商缓存**(Last-Modified 和 ETag):协商缓存是在浏览器发送请求时**与服务器进行通信**,通过比较资源的标识符来确定是否使用缓存。**(一般是查看是否有资源需要更新,无更新则使用缓存 + 返回 304 Not Modified)**
1. `Last-Modified` 和 `If-Modified-Since`:服务器在响应头中返回资源的**最后修改时间(`Last-Modified`)**,浏览器在后续请求中通过 `If-Modified-Since` 头字段将上次请求返回的最后修改时间发送给服务器。如果资源在此时间后没有发生变化,服务器会返回 `304 Not Modified` 状态码,告诉浏览器可以使用缓存。
2. `ETag` 和 `If-None-Match`:服务器在响应头中返回资源的**唯一标识符**(`ETag`),浏览器在后续请求中通过 If-None-Match 头字段将上次请求返回的 `ETag` 发送给服务器。如果资源的 `ETag` 与**服务器上的匹配**,服务器会返回 `304 Not Modified` 状态码。
Q: 为什么有了 Last-Modified 还要有 ETag?
A: 客户端和服务器的时钟可能不一致,使用 etag 更为精准
**注意:强缓存优先级高于协商缓存,当强缓存生效时直接使用缓存,不会发送请求到服务器。**
## XSS 和 CSRF
**XSS攻击:** 跨站脚本攻击。(比如评论留言 window.alert(1) 这样每个访问到页面的人都会出现弹窗)
`攻击者脚本`嵌入`被攻击网站`,获取用户cookie等隐私信息。
将受害者重定向到一个由攻击者控制的网站,在受害者的机器上进行一些恶意操作
[存储型](https://juejin.cn/post/6945277278347591688#存储型)(持久型)、[反射型](https://juejin.cn/post/6945277278347591688#反射型)(非持久型)、[基于DOM](https://juejin.cn/post/6945277278347591688#基于DOM)。
**防御**:服务器对输入脚本进行过滤或转码;
使用 HttpOnly 属性来保护我们Cookie的安全。
CSP内容安全策略:
限制加载其他域下的资源文件,
禁止向第三方域提交数据,
禁止执行内联脚本和未授权的脚本;
**CSRF攻击:**跨站请求伪造。
`已登录用户`访问`攻击者网站`,攻击网站向被攻击网站发起恶意请求(利用浏览器会自动携带cookie)。
**CSRF攻击就是黑客利用了用户的登录状态(利用了你的cookie),并通过第三方的站点来做一些坏事。**
防御:**通过set-cookie字段设置Cookie时,可以带上SameSite=Lax选项**
# 计算机网络 - 课程笔记
## HTTP 与 HTTPS
为了保证这些隐私数据能加密传输,让`HTTP`运行安全的`SSL/TLS`协议上,即 HTTPS = HTTP + **SSL/TLS**,通过 `SSL`证书来验证服务器的身份,并为浏览器和服务器之间的通信进行加密
`SSL` 协议位于`TCP/IP` 协议与各种**应用层协议**之间
HTTP 协议的数据传输是明文的,是不安全的,HTTPS 使用了 SSL/TLS 协议进行了加密处理,相对更安全。
HTTP 和 HTTPS 使用连接方式不同,默认端口也不一样,HTTP 是 80,HTTPS 是 443
建立连接 - CA证书验证服务器 - 协商加密协议 - 生成会话公私钥
## 址栏输入 URL 敲下回车后发生了什么 ⭐
1. URL 解析
- 首先判断输入的是一个合法的`URL` 还是一个待搜索的关键词,然后解析URL,获得 协议 域名/IP 端口 路径 参数
- 如果站点开启 HSTS ,会使用强制客户端使用 HTTPS 访问页面
2. 检查浏览器缓存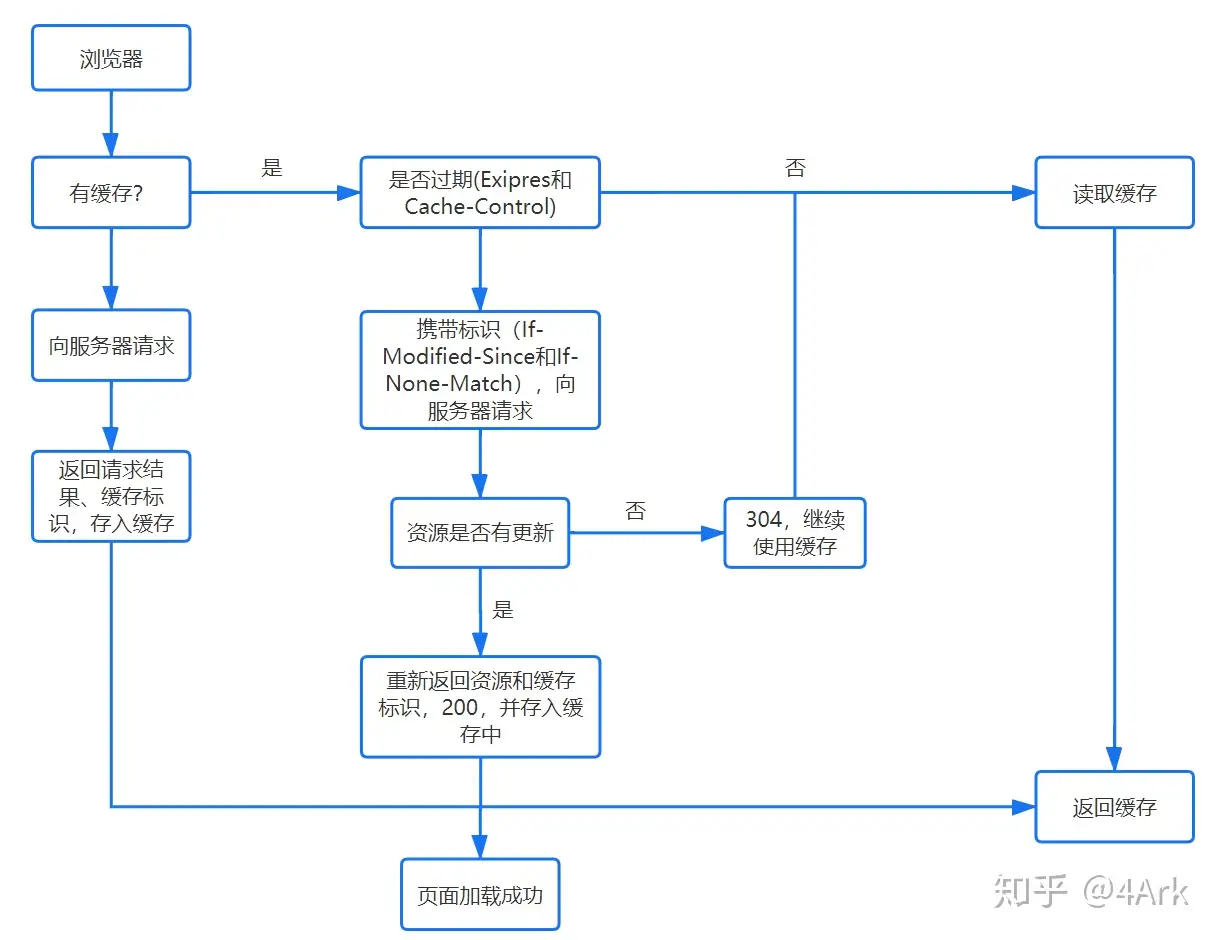
3. DNS 查询
- 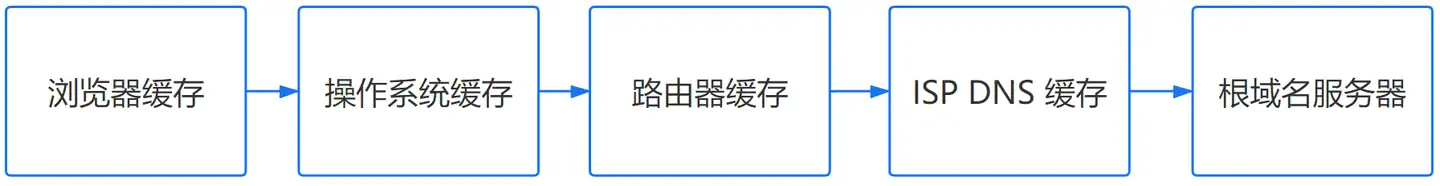
- 递归+迭代查询域名对应的 IP 地址
- 递归方式:一路查下去中间不返回,得到最终结果才返回信息(浏览器到本地DNS服务器的过程)
- 迭代方式,就是本地DNS服务器到根域名服务器查询的方式。
4. TCP 连接
- TCP/IP 分为四层(**网络接口层、网络层、传输层、应用层**),在发送数据时,每层都要对数据进行封装
- 应用层:通过得到的IP地址构造HTTP报文
- 传输层:通过三次握手与服务器建立 TCP 连接(发送,确认收到,确认 确认收到)
- TCP 3 次握手连接:浏览器所在的客户机向服务器发出连接请求报文(SYN标志为1);服务器接收报文后,同意建立连接,向客户机发出确认报文(SYN,ACK标志位均为1);客户机接收到确认报文后,再次向服务器发出报文,确认已接收到确认报文;此处客户机与服务器之间的TCP连接建立完成,开始通信。
- 四次挥手(客户端请求断开,服务端确认收到,服务端请求断开,客户端确认收到)
5. 请求与响应
- 浏览器构造HTTP请求进行通信
- 浏览器接收到来自服务器的响应资源后
- 首先查看响应头,根据不同状态码做不同的事(比如重定向)
- 响应资源进行了压缩(比如 gzip),还需要进行解压
- 对响应资源做缓存
- 根据响应资源里的 MIME 类型去解析响应内容(HTML、Image……)
6. 页面渲染
- <img src="https://pic3.zhimg.com/80/v2-d2ea43fca9c994d20b2d83b94358111e_1440w.webp" alt="img" style="zoom:50%;" />
- 解析 HTML,构建 DOM 树
- 解析 CSS ,生成 CSS 规则树
- 合并 DOM 树和 CSS 规则,生成 render 树
- 布局 render 树( Layout / reflow ),负责各元素尺寸、位置的计算
- 绘制 render 树( paint ),绘制页面像素信息
- 浏览器会将各层的信息发送给 GPU,GPU 会将各层合成( composite ),显示在屏幕上
## WebSocket
WebSocket,是一种网络传输协议,位于`OSI`模型的应用层。
客户端和服务器只需要完成一次握手,两者之间就可以创建持久性的连接,并进行双向数据传输
WebSocket 是一种实时双向通信协议,与 HTTP 协议相比,有以下几个主要区别:
- 连接方式:WebSocket 提供持久的连接,通过握手过程建立连接后保持打开状态,而 HTTP 是无状态的,每次请求都需要重新建立连接。
- 数据格式:WebSocket 支持文本和二进制数据的传输,而 HTTP 主要是传输文本数据。
- 数据传输方式:WebSocket 实现了全双工通信,客户端和服务器可以同时发送和接收数据,而 HTTP 是单向的,客户端发起请求,服务器响应数据。
- 协议标识:WebSocket 使用 ws:// 或 wss:// 前缀标识,而 HTTP 使用 http:// 或 https://
应用:实时场景
- 弹幕
- 实时聊天
## http 无状态
http 不会为了下次连接所需要的信息而维护这次连接(也就是不记得你来过,刷新页面,不记得你登录过了)
而解决无状态问题就是使用 cookie 与 session
当发送的请求「属于子域名/同域名,http/s协议相同」且请求路径属于「cookie中设置的path属性」时,该请求会**自动带上cookie**,以**告知之前的状态**
## TCP / UDP
- UDP 不提供复杂的控制机制,利用 IP 提供面向无连接的通信服务
- 传输途中**出现丢包,UDP 也不负责重发**
- 当包的到达顺序出现**乱序**时,UDP没有纠正的功能。
- 并且它是将应用程序发来的数据在收到的那一刻,**立即按照原样发送**到网络上的一种机制。即使是出现**网络拥堵**的情况,UDP 也无法进行流量控制等避免网络拥塞行为
---
- TCP充分地实现了数据传输时各种控制功能,可以进行丢包时的**重发控制**,还可以对次序乱掉的分包进行**顺序控制**。而这些在 UDP 中都没有。
- 此外,TCP 作为一种面向有连接的协议,只有在**确认通信对端存在时**才会发送数据,从而可以控制通信流量的浪费。
- 根据 TCP 的这些机制,在 IP 这种无连接的网络上也能够实现高可靠性的通信( 主要通过检验和、序列号、确认应答、重发控制、连接管理以及窗口控制等机制实现)
| | TCP | UDP |
| -------- | -------------------------------- | ------------------------------ |
| 可靠性 | 可靠 | 不可靠 |
| 连接性 | 面向连接 | 无连接 |
| 报文 | 面向字节流 | 面向报文 |
| 效率 | 传输效率低 | 传输效率高 |
| 双共性 | 全双工 | 一对一、一对多、多对一、多对多 |
| 流量控制 | 滑动窗口 | 无 |
| 拥塞控制 | 慢开始、拥塞避免、快重传、快恢复 | 无 |
| 传输效率 | 慢 | 快 |
## TCP/IP
四层体系:网络接口层、网络层、传输层、应用层
IP 在 网络层,负责网络间的**寻址数据传输**
TCP 在 传输层,负责提供可靠的**传输服务**
HTTP、DNS 在 **应用层**,负责实现一切与应用程序相关的功能
## HTTP 状态码
- 1 表示临时响应[请求已被接受,需要继续处理]
- 100 :临时响应,通知客户端它的部分请求已经被服务器接收,应当继续发送请求的剩余部分
- 2 表示成功
- 200(成功):请求已成功,请求所希望的响应头或数据体将随此响应返回
- **强缓存启用** 显示的也是 200 (from cache),**但并没有http请求**
- 204(无内容):服务器成功处理请求,但没有返回任何内容
- 206 (部分内容):客户端请求一部分资源,服务端成功响应,返回一部分资源
- 3 表示重定向
- 301(永久性重定向):请求的网页已永久移动到新位置。 服务器返回此响应(对 GET 或 HEAD 请求的响应)时,会**自动将请求者转到新位置**,可用于搜索引擎爬虫提升主站权重
- 302(临时性重定向): 服务器目前从不同位置的网页响应请求,但请求者应继续使用原有位置来进行以后的请求
- **304 Not Modified.**(**协商缓存**未被修改,可直接使用) 说明无需再次传输请求的内容,也就是说**可以使用缓存**的内容。
- 4 表示客户端请求错误
- 401 unauthorized 要求身份验证
- 403 forbidden 服务器拒绝请求
- 404 not found 服务器无法找到请求的资源
- 408(请求超时): 服务器等候请求时发生超时
- 5 表示服务器错误
- 500 internal server error (服务端执行请求时发生了错误)
- 502(错误网关): 服务器作为网关或代理,从上游服务器收到无效响应
- 503 service unavailable 服务器目前无法使用(由于超载或停机维护)
- 504(网关超时): 服务器作为网关或代理,但是没有及时从上游服务器收到请求
- 505(HTTP 版本不受支持): 服务器不支持请求中所用的 HTTP 协议版本
## HTTP 请求头
HTTP 头字段,是指在HTTP 的**请求和响应消息中**的消息**头部分**
通过配合请求头和响应头,可以满足一些场景的功能实现:
### **会话状态**
`cookie`,类型为「小型文本文件」,指某些网站为了辨别用户身份而储存在用户本地终端上的数据,**通过响应头`set-cookie`决定**
### **协商缓存**
利用`【Last-Modified,If-Modified-Since】`和`【ETag、If-None-Match】`这两对请求头响应头来管理的
- `Last-Modified` 表示本地文件最后修改日期,浏览器会在request header加上`If-Modified-Since`(上次返回的`Last-Modified`的值),询问服务器在该日期后资源是否有更新,有更新的话就会将新的资源发送回来
- `Etag`就像一个指纹,资源变化都会导致`ETag`变化,跟最后修改时间没有关系,`ETag`可以保证每一个资源是唯一的
- `If-None-Match`的header会将上次返回的`Etag`发送给服务器,询问该资源的`Etag`是否有更新,有变动就会发送新的资源回来
### **强制缓存**
**不需要发送请求**到服务端,根据**请求头**`expires`和`cache-control`判断是否命中强缓存
| 字段名 | 说明 | 示例 |
| ----------------- | ----------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | -------------------------------------------------------------------------------- |
| Accept | 能够接受的回应内容类型(Content-Types) | Accept: text/plain |
| Accept-Charset | 能够接受的字符集 | Accept-Charset: utf-8 |
| Accept-Encoding | 能够接受的编码方式列表 | Accept-Encoding: gzip, deflate |
| Accept-Language | 能够接受的回应内容的自然语言列表 | Accept-Language: en-US |
| Authorization | 用于超文本传输协议的认证的认证信息 | Authorization: Basic QWxhZGRpbjpvcGVuIHNlc2FtZQ== |
| Cache-Control | 用来指定在这次的请求/响应链中的所有缓存机制 都必须 遵守的指令 | Cache-Control: no-cache |
| Connection | 该浏览器想要优先使用的连接类型 | Connection: keep-alive Connection: Upgrade |
| Cookie | 服务器通过 Set- Cookie (下文详述)发送的一个 超文本传输协议Cookie | Cookie: $Version=1; Skin=new; |
| Content-Length | 以 八位字节数组 (8位的字节)表示的请求体的长度 | Content-Length: 348 |
| Content-Type | 请求体的 多媒体类型 | Content-Type: application/x-www-form-urlencoded |
| Date | 发送该消息的日期和时间 | Date: Tue, 15 Nov 1994 08:12:31 GMT |
| Expect | 表明客户端要求服务器做出特定的行为 | Expect: 100-continue |
| Host | 服务器的域名(用于虚拟主机 ),以及服务器所监听的传输控制协议端口号 | Host: en.wikipedia.org:80 Host: en.wikipedia.org |
| If-Match | 仅当客户端提供的实体与服务器上对应的实体相匹配时,才进行对应的操作。主要作用时,用作像 PUT 这样的方法中,仅当从用户上次更新某个资源以来,该资源未被修改的情况下,才更新该资源 | If-Match: "737060cd8c284d8af7ad3082f209582d" |
| If-Modified-Since | 允许在对应的内容未被修改的情况下返回304未修改 | If-Modified-Since: Sat, 29 Oct 1994 19:43:31 GMT |
| If-None-Match | 允许在对应的内容未被修改的情况下返回304未修改 | If-None-Match: "737060cd8c284d8af7ad3082f209582d" |
| If-Range | 如果该实体未被修改过,则向我发送我所缺少的那一个或多个部分;否则,发送整个新的实体 | If-Range: "737060cd8c284d8af7ad3082f209582d" |
| Range | 仅请求某个实体的一部分 | Range: bytes=500-999 |
| User-Agent | 浏览器的浏览器身份标识字符串 | User-Agent: Mozilla/5.0 (X11; Linux x86_64; rv:12.0) Gecko/20100101 Firefox/21.0 |
| Origin | 发起一个针对 跨来源资源共享 的请求 | Origin: http://www.example-social-network.com |
# Git
分布式版本控制软件,保存每一个提交节点的文件快照
- 工作区:**相当于本地写代码的区域**,如 git clone 一个项目到本地,相当于本地克隆了远程仓库项目的一个副本
- 暂存区:暂存区是一个文件,保存了**下次将提交的文件列表信息**,一般在 Git 仓库目录中(git add .)
- 本地仓库:提交更新,找到暂存区域的文件,将快照永久性存储到 Git 本地仓库(git commit)
- 远程仓库:远程的仓库,如 github(git push)

通过`git branch`可以创建一个分支,但并不会自动切换到新分支中去
通过`git checkout`可以切换到另一个`testing`分支
### 命令
- git branch <新分支名> 基于当前分支,新建一个分支
- git checkout <分支名> 切换到本地某个分支
- git checkout -b <新分支名> 把基于当前分支**新建**分支,**并切换**为这个分支
- git merge <分支名> 合并分支(一般**站在主分支**上**合并**其他分支)
- git pull [remote] [branch] 拉取远程仓库的分支与本地当前分支合并
- git fetch 只拉取代码,不合并(pull 是拉取 + 合并)
- 回滚
- `reset`:真实硬性回滚,目标版本后面的提交记录全部丢失了
- `revert`:同样回滚,这个回滚操作相当于一个提价,目标版本后面的提交记录也全部都有
- git stash 暂存未提交的变化,此时可以切换到其他分区进行开发,git stash pop 恢复暂存的变化,继续开发
### git pull 和 git fetch
`git fetch`是将远程主机的最新内容拉到本地仓库(而非工作区),用户在检查了以后**决定是否合并**到工作本机分支中。
而`git pull` 则是将远程主机的最新内容拉下来后**直接合并**,即:`git pull = git fetch + git merge`,这样**可能会产生冲突**,需要手动解决
### git merge 和 git rebase
` git merge`与`git rebase` 都有相同的作用,都是将一个分支的提交合并到另一分支上,但是在原理上却不相同
#### git merge
通过`git merge`将当前分支与`xxx`分支合并,产生的新的`commit`对象有两个父节点
如果“指定分支”本身是当前分支的一个直接子节点,则会产生快照合并
举个例子,`bugfix`分支是从`master`分支分叉出来的,如下所示:

合并`bugfix`分支到`master`分支时,如果`master`分支的状态没有被更改过,即 `bugfix`分支的历史记录包含`master`分支所有的历史记录
所以通过把`master`分支的位置移动到`bugfix`的最新分支上,就完成合并
如果`master`分支的历史记录在创建`bugfix`分支后又有新的提交,如下情况:

这时候使用`git merge`的时候,会生成一个新的提交,并且`master`分支的`HEAD`会移动到新的分支上,如下:

从上面可以看到,会把两个分支的最新快照以及二者最近的共同祖先进行三方合并,合并的结果是生成一个新的快照
#### git rebase
同样,`master`分支的历史记录在创建`bugfix`分支后又有新的提交,如下情况:

通过`git rebase`,会变成如下情况:

在移交过程中,如果发生冲突,需要修改各自的冲突,如下:

`rebase`之后,`master`的`HEAD`位置不变。因此,要合并`master`分支和`bugfix`分支

从上面可以看到,`rebase`会找到不同的分支的最近共同祖先,如上图的`B`
然后对比当前分支相对于该祖先的历次提交,提取相应的修改并存为临时文件(老的提交`X`和`Y`也没有被销毁,只是简单地不能再被访问或者使用)
然后将当前分支指向目标最新位置`D`, 然后将之前另存为临时文件的修改依序应用
通过`merge`合并分支会新增一个`merge commit`,然后将两个分支的历史联系起来
其实是一种**非破坏性的操作**,对现有分支不会以任何方式被更改,但是会导致历史记录相对复杂
`rebase`会将整个分支移动到另一个分支上,有效地整合了所有分支上的提交
主要的好处是历史记录更加清晰,是在原有提交的基础上将差异内容反映进去,消除了 `git merge` 所需的不必要的合并提交
# 设计模式
- 单例模式
- 保证一个类仅有一个实例,并提供一个访问它的全局访问点。实现的方法为先判断实例存在与否,如果存在则直接返回,如果不存在就创建了再返回,这就确保了一个类只有一个实例对象
- 工厂模式
- 工厂模式是用来创建对象的一种最常用的设计模式,不暴露创建对象的具体逻辑,而是将将逻辑封装在一个函数中,那么这个函数就可以被视为一个工厂
- 策略模式
- 策略模式(Strategy Pattern)指的是定义一系列的算法,把它们一个个封装起来,目的就是将算法的使用与算法的实现分离开来
- 中介者模式
- 中介者模式的定义:通过一个中介者对象,其他所有的相关对象都通过该中介者对象来通信,而不是相互引用,当其中的一个对象发生改变时,只需要通知中介者对象即可
- 通过中介者模式可以解除对象与对象之间的紧耦合关系
- 观察者模式
- 观察者模式定义了对象间的一种一对多的依赖关系,当一个对象的状态发生改变时,所有依赖于它的对象都将得到通知,并自动更新
- **发布订阅模式**
- 消息的发送者(称为发布者)**不会**将消息直接发送给**特定**的接收者(称为订阅者)。而是将发布的消息分为**不同的类别**,无需了解哪些订阅者可能存在。同样的,订阅者可以表达对一个或多个类别的兴趣,只接收感兴趣的消息,无需了解哪些发布者存在
- 所以重点在于**消息的类别**,**发布者按类别发布,订阅者按类别订阅**,类似**频道**
- 装饰者模式
- 装饰者模式的定义:在不改变对象自身的基础上,在程序运行期间给对象动态地添加方法
- 通常运用在原有方法维持不变,在原有方法上再挂载其他方法来满足现有需求
# Node.js
在Node.js中,使用Express框架来创建一个简单的服务器,并设置一个接口来监听前端的请求,并返回JSON数据。
下面是一个基本的示例代码,这段代码将创建一个监听在localhost:5173的服务器,并且当访问/getlist路由时,返回一段JSON数据:
```js
const express = require('express');
const app = express();
const PORT = 5173;
app.get('/getlist', (req, res) => {
const data = {
status: 'success',
message: 'Data fetched successfully',
data: [
{ id: 1, name: 'Item 1' },
{ id: 2, name: 'Item 2' }
]
};
res.json(data);
});
app.listen(PORT, () => {
console.log(`npm install express; node server.js`);
console.log(`Server is running on http://localhost:${PORT}`);
});
先安装Express
npm install express
然后,将上述代码保存为一个文件(如server.js),在该文件所在的目录下打开终端,运行命令** node server.js** 来启动服务器。
之后,当你在浏览器或任何HTTP客户端访问localhost:5173/getlist时,你将看到返回的JSON数据。
Nuxt.js
.nuxt
Nuxt 使用.nuxt/目录在开发中生成您的Vue应用程序。整个目录将在运行nuxt dev时重新创建。
.output
Nuxt在为生产构建应用程序时创建.output目录。整个目录将在运行nuxt build时重新创建。
assets
assets/ 目录用于添加构建工具(webpack或Vite)将处理的所有网站资产。
该目录通常包含以下类型的文件:
Stylesheets (CSS, SASS, etc.)
Fonts
Images 它不会从public/目录中提供。
如果你想从服务器上提供资产,我们建议看一下public/目录。
components
components/目录是您放置所有Vue组件的地方,然后可以在您的页面或其他组件中导入这些组件(自动导入)。
如果你在嵌套目录中有一个组件,例如:
| components/
–| base/
—-| foo/
——| Button.vue
然后组件的名称将基于它自己的路径、目录和文件名,删除重复的段。因此,组件的名称将是:<BaseFooButton />
为了清晰起见,我们建议组件的文件名与其名称相匹配。(所以,在上面的例子中,你可以将Button.vue重命名为BaseFooButton.vue。)
composables
Nuxt 3使用composables/目录使用auto-imports自动将Vue组合导入到应用中!
content
// Method 1: Using named export |
用法: 你现在可以在 .js, .ts 和 .vue 文件中使用自动导入组合
<template> |
layouts
pages
Nuxt 提供了一个基于文件的路由,在您的web应用程序中使用Vue Router在底层创建路由。
plugins
server
public 目录直接服务于服务器根目录,包含必须保留其名称的公共文件(例如:robots.txt)或可能不会更改(例如:favicon.ico)。
算法 - 数据结构课程笔记
十大排序
- 冒泡排序:想象一杯啤酒,气泡会逐渐从底部浮到顶部。冒泡排序就是通过不断比较相邻的两个元素,如果它们的顺序错误就把它们交换过来,直到整个序列变成有序。
- 选择排序:就像在一堆数中选择最小(或最大)的那样,将其放在序列的起始位置,然后在剩余未排序元素中继续寻找最小(或最大)元素,然后放到已排序序列的末尾。这样,每次都会将未排序的最小(或最大)元素放到已排序序列的末尾,直到全部排序完毕。
- 插入排序:就像玩扑克牌时,一张张拿牌并插入到正确的位置。从第一个元素开始,该元素可以认为已经被排序;取出下一个元素,在已经排序的元素序列中从后向前扫描;如果该元素(已排序)大于新元素,将该元素移到下一位置,如此重复,直到找到已排序的元素小于或者等于新元素的位置,将新元素插入到该位置后。
- 快速排序:就像在一个房间里,选一个人作为基准,比他矮的站左边,比他高的站右边。然后对左右两边的人再进行同样的操作,直到每个人的位置都确定下来。
- 希尔排序:是插入排序的一种更高效的改进版本,也称为缩小增量排序。它首先比较较远的元素,然后逐步减小排序的间隔,直到为1,此时就变成了普通的插入排序。
- 归并排序:就像将一堆扑克牌分成两堆,然后分别排序,再合并成一堆。这个过程会一直重复,直到所有的牌都排序好。这种“分而治之”的策略是归并排序的核心。
- 堆排序:就像把一堆书按照大小顺序堆叠起来,我们首先将所有的书都堆成一个大堆,然后每次从最顶部的书开始,将其与最后一本书交换位置,然后重新调整剩下的书堆,使其保持书堆的特性,重复这个过程,直到所有的书都按顺序排列好。
- 计数排序:如果你知道一个人在一群人中的排名,那么这个人就可以直接去到他的位置,而不需要和其他人比较。计数排序就是先统计每个元素的出现次数,然后根据元素的大小,确定它在排序后的序列中的位置。
- 桶排序:如果你需要将一堆苹果按照大小排序,你可能会准备几个桶,每个桶放一定范围内的苹果,然后分别对每个桶中的苹果进行排序,最后再将所有桶中的苹果按顺序取出,这就完成了排序。桶排序就是这个原理。
- 基数排序:就像你在排列一堆数字,你可能会先按照最后一位来排序,然后按照倒数第二位,然后是倒数第三位…直到所有的位数都排序过,这样就完成了整个排序过程。基数排序就是这样工作的。
笔记
程序 = 数据结构 + 算法
时间复杂度只关注最高数量级,且与之系数也没有关系
时间复杂度有:
- O(1) 常数型
- O(log n) 对数型
- O(n) 线性型
- O(nlogn) 线性对数型
- O(n^2) 平方型、立方型、k次方型
- O(2^n) 指数型
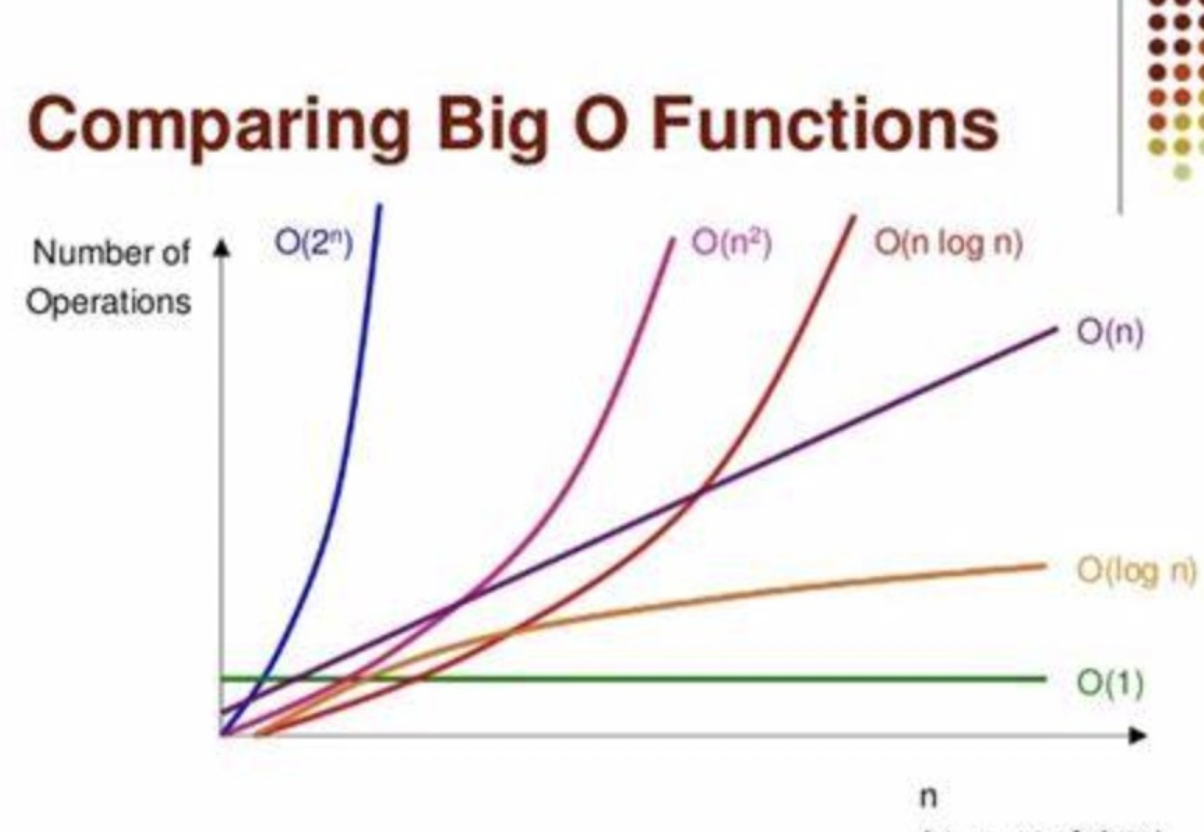
常见的数据结构有如下:
- 数组
- 栈
- 队列
- 链表
- 树
- 图
- 堆
- 堆是一种特殊的树形数据结构,每个结点都有一个值,特点是根结点的值最小(或最大),且根结点的两个子树也是一个堆
- 堆中某个结点的值总是不大于或不小于其父结点的值
- 堆总是一棵完全二叉树
- 关于堆的插入和删除时间复杂度都是
Olog(n),原因在于包含n个节点的完全二叉树,树的高度不会超过log2n
- 散列表
- 若结构中存在关键字和
K相等的记录,则必定在f(K)的存储位置上,不需比较便可直接取得所查记录
- 若结构中存在关键字和
操作系统 - 课程笔记
操作系统在计算机系统中位于「计算机硬件 和 用户软件」之间,OS本身也是一种系统软件。
进程
操作系统中最核心的概念就是进程,进程是对正在运行中的程序的一个抽象,是系统进行资源分配和调度的基本单位
进程是动态的,有点类似于「动态的程序」
操作系统的其他所有内容都是围绕着进程展开的,负责执行这些任务的是CPU
线程
线程(thread)是操作系统能够进行运算调度的最小单位,其是进程中的一个执行任务(控制单元),负责当前进程中程序的执行
一个进程至少有一个线程,一个进程可以运行多个线程,这些线程共享同一块内存,线程之间可以共享对象、资源,如果有冲突或需要协同,还可以随时沟通以解决冲突或保持同步
进程管理 - 重中之重
进程的同步和进程的调度
进程是操作系统进行资源分配
进程往往是操作系统调度的基本标准 (√)
在内存当中要运行的时候,都要获得CPU,这个过程中就会存在对CPU资源的争抢,那么我们称之为调度,我们的这个调度算法,有时间片轮转 抢占式,短作业优先 抢占式,先来先服务 非抢占式,高响应比优先 非抢占式。那么这些抢占占式非抢占式,就看是否是他主动放弃CPU啊,这种就是调度算法,
让你去设计一个调度算法,这个调度算法既满足IO的又能够照顾到的计算量大的
要用到的这个资源里面,最常见的是两种,一个是内存。内存他要处理数据的话,首先要把数据加载到内存里面来,那这样一来就得需要有内存资源
第二个的话,比如说输出的这个资源,比如说打印机输入的资源,比如说扫描仪,而这些都是临界资源,我们说过的临界资源的话,一次性允许被一个进程所使用。那么如果有多个进程交替的去占用CPU之后,都需要用到这种资源的话,就很有可能会引起一个叫做死锁
进程的推进顺序不当,就进入死锁,那么如何来检测死锁,如何来预防死锁,如何来避免死锁,什么银行家算法,四个必要条件里面破坏一个
在安全状态的情况下,那么他要申请的资源,最重要的就是内存,内存的资源,并不是无穷无尽的,我们的内存,是以位进行编制的,内存既可以按地址一个字节一个字节去访问,也可以以块为单位,进行一次性的读写。那么这里面的块,就是跟我们磁盘上的块的大小是一样的,那么块内的地址数量在内存里面,叫做页内偏移,就是跟我们内存里面的一个分块的块的大小一样的,那么从而使得在我们将外部的文件,就是程序运行过程中要处理的数据加载到内存的时候,逻辑上相邻的。
如果采用分页的话,物理上不一定相邻的,但是在页内,逻辑上相邻的,物理上一定是相邻的
申请到内存地址之后,我们把数据放到了这个内存里面来,但是,每个进程,并不能无穷的去申请内存地址空间,为此我们就提出了一个叫虚拟存储器的概念,虚拟存储器在进程提出内存空间请求的时候,他有可能要面临着淘汰和置换的问题。淘汰和置换啊,那么这个,就是我们所谓的存储及管理怎么跟我们的这个进程的运行过程相关联起来,因为进程要运行,一定会执行代码,通过执行代码去处理数据。
然后这个代码,我们在整个进程实体里面,我们有三样东西,一个就是我们的代码段,一个就是我们的数据段或者叫代码数据,还有一个就是用来统领代码数据的PCB,一个PCB是进程存在于系统中的唯一标志,也就是说它的代码和数据可能还在硬盘上,或者在交换区。但是如果这个进程存在,那么它的PCB一定是在内核里啊,那么这个,有了这个PCB之后,就成为了我们去破除死锁的一个依据,我们去制定相应的调度算法,然后,也可以,设置了相应的同步规则,总而言之的话,能够通过互斥或者同步的方式。通过信号量或者是关中断、开中断来使得多个共享。
管程就是管进程的数据结构,这个数据结构里面,管理的就是资源,通过对资源的进行访问的这些代码,提供统一资源的接口给外面的进程去使用,你比如说你要申请资源的话,那么你就用我给你的这个系统调用,因为这个管程内部的函数都是系统调用,要想能够通过管程内部的函数去取得管程所管理的资源。对它进行一个使用,那么必须要把这个函数提供给用户,用户程序,那么用户程序能够调用这些函数,前提是这个函数就是系统调用,就是我们第一章讲的系统调用是用户程序取得操作系统服务的唯一的方式。
进程状态的转换,要会解决问题:给你一个设计目标,能画出一个正确的状态转换(特别注意,进程状态图里不同状态对应不同的圈)
原语上来第一句就是关中断,使得你的CPU就不能再去检测到中断了,然后完了之后,下一步,就是原于内容全部执行完开中断,这个时候,CPU才能够正常的运行
系统调用说白了之后,它是一个比较大的一个东西,它内部是包括原语的,它是包括原语,那我们常见的系统调用,有创建进程fork,必考
进程同步
我们主要的就是考察进程同步搅合在一起的一个题目,二十分
解题从三方面下手,第一要定义清楚:有哪些同步,有哪些进程(通常是人、有主观能动性)、罗列进程的所有动作。第二:分析同类进程的每个动作之间是否存在同步和互斥,不同类进程之间是否存在同步和互斥。第三:开始定义信号量、一定要给初始值(同步信号上的初始值是0、互斥信号量初始值是)
三类同步互斥问题:
生产者消费者 empty full 缓冲
读者写者问题,单边桥
哲学家就餐问题了
需要明白:死锁原因、如何破除死锁
死锁原因:1.资源不足 2.推进顺序不当
周转时间、平均周转时间 一定要会算,必考题
进程调度算法,做两件事情,第一个:选中一个就绪队列中的进程。第二个:保存现场、恢复现场
那么挑选的话,总共有两大类,第一个是 抢占式/剥夺式,另一个是 非抢占/非剥夺。
在每一种调度算法里,每一个进程都有一个到达系统的时间。以及,最终被执行完的时间,那么这两个时间的差,就是这个进程的周转时间。包括中间被打断了,中间被抢了CPU。从刚进去的时间开始,到他最后出来为止,这整一个时间段内。必考,不同算法都要会
进程通信
进程通信,我们总共有四大类,第一个信号量,这叫低级通信,因为它通信的量非常少,就是对这个锁进行一个关和开,所以的话,我们叫做低级通信,那么随着传输的数据量越来越大,比如说共享存储器管道,还有,像我们的消息缓冲对列,随着这个共享的内容数量越来越多,比如说字节数越来越多,还有,共享信息的结构越来越复杂。我们,就把这些叫做高级通信,高级通信,但是高级通信,是建立在低级通信的基础上的,比如说消息缓冲队列里面,消息缓冲是一个临界资源对他的进行使用,你就想想生产者消费者。它是建立在信号量基础上来实现的。然后,管道这里面非常重要,管道的话,有两类管道啊,两类管道啊,第一类,叫做有名管道,第二类叫做无名管道,那扯淡的,那是这样,这哪了无有名管道。它是有目录项的,是这个意思啊,它有目录项的,但是,它只存在于内存当中。无名管道,没有目录,像它在内存当中,仅仅只有一个数据结构,仅仅只有一个数据结构无名管道,无名管道,我们又称之为,叫做先进先出文明,或者叫做那个那个那个那个叫做呃,诶。有点忘记了啊,昨天刚这个把这道题目放上去之后就忘记了,自从中了羊之后,这个记忆力衰退了。反正大家一定要去看啊,好像是先进先出,不一定啊,不一定啊,这个不一定啊,但是有名无名这两个要去看,
共享存储器这个。是最原始,结构最简单,需要自己去实现同步与互斥的这么一个通信就是你一个。共享的。然后完了之后。进行通信的进程之间,关于这一块,空间,只要传列的地址就可以
银行家算法,一旦遇到银行家算法那个这个这个安全检测型算法有个表格的,千万不要忘记了啊,资源分配的情况要写清楚,还有一个,就是安全序列有没有对吧?呃,那么这里面,有一个,比较有意思的,就比如说,哦,还有一个很重要,他这患者。资源分配图,资源分配图啊选择题,资源分配图就是当前是否已经是过,你得知道怎么去怎么去解啊好现城。用户去现场。内核。现在。一个线程如果阻塞,那么同属。某一进程的所有其他线上是否会主上,这个我们在章节测验里面是做过的,那么说过来就是章节测验,每一章的章节测验你都认认真真仔仔细细的去看一遍
存储器管理
存储器管理在整张试卷里面大概是28分,
选择题四道,解析题两题8分,大题两题16分
存储器管理最主要的就是要解决两个问题,两者相辅相成
- 存储器的分配与回收
- 地址重定位
存储器分配与回收,主要有两大类,第一类叫做连续存储管理:逻辑上相邻的,物理上也相邻的啊,这种就叫做连续的。那么这样一来,在内存当中,就是一块连续的空间,就是针对每一个进程的。
第二个叫做离散式:同一个进程的代码和数据分布在整个内存的角角落落,逻辑上相邻的,物理上不一定相邻,我们叫做离散式,有些是全在内存,有些是一部分在内存,总而言之,它都是离散。而连续存储管理,是不管你用与不用都在内存。
连续存储管理分为两大类:
第一类固定分区分配,事先将内存分割为大小不同或大小相同的固定的区域,比如说基本分析。固定分区分配是空间利用率低,容易造成内部碎片,但是分配率回收的效率高。
第二类动态分区分配,优势就是内存利用率高,但带来的问题就是有很多细小的外部碎片。效率低,算法复杂,但空间利用率高。
伙伴系统处于两者之间。效率和效果之间取个折中的伙伴。一次分配多次脱分,一次脱分对不对,一次回收,多次合并。伙伴系统必考
离散存储管理
离散存储管理内存利用率高,这个一页一页的都给它分好,分的越细越好,但带来了内存的浪费,因为页数越多,也就意味着页表就得越少,一级不够还得分两级,内存浪费严重,同时分值越多,一个CPU产生了一个逻辑地址,如果这个存储空间存储器,采用分页管理的话,那么在没有这个快表支持的情况下,你要知道它要通过页表才能够完成地址转换的,那么这样一来,分值越多,对内存的访问次数就会越多,从而的话,数据获取的效率就很低了啊。
逻辑上完整的内容一旦采用分页之后,可能被分到不同的内存区域,对这些分布在不同内存区域的数据进行统一的权限管理和控制保护就很困难。于是就有了分段,分段的好处就是。保护比较简单。也适合于用户去动态加载。
分页管理的话,其实就是我们之前存储器分配里面,对应的固定分区分配
段式存储管理,就是我们在连续存储管理里面,提到的可用的方法,动态分区分配,所以,这个方法上,是相通用的,一定要注意啊,尽管一个是连续,一个是离散。好,然后,把两者相结合,就给它分页式,如果,把整个程序只要加载一部分就能运行,需要的时候再进行加起来,就成为了虚拟的分页,虚拟的分段,虚拟的断线式,大家明白了啊啊,就是说虚拟存储器。不是只有请求分页的,还有请求分段,还有请求分段分页相结合的都有,那么这个,就讲完了,这个存储空间的分配与回收,那下一个问题,
地址映射,对于连续存储来讲,比如说固定分区分配,那么只要知道首地址,逻辑上的首地址在物理上的这个首地址是什么就可以了,因为它都是放在一起的,通过那个固定分区的那张表就解决问题了。
那么如果是动态分区的,到了内存之后可能还会被移动,但是逻辑上相邻的,物理上依然相邻,那我们只要用一个重定位寄存器就搞定了。整一个代码段、数据段在内存中被移动之后,我们只要把这个移动之后的首地址放到进程对应进程的 pcb 里面去就搞定了。那么当CPU切换到这个进程之后,我们只要把 pcb 里面的首地址拿出来放到重定位寄存器里面去,那么接下来?在CPU产生的任何一个逻辑上,逻辑地址上,我们通过重定位寄存器就可以快速的定位到他在内存中的地址,如果用重定位寄存器的话,一个逻辑地址要访问内存中的物理地址只要一次,那么当你把一个连续的一个代码或者数据把它打散了之后,不管你采用分页还是分段,你都要通过相应的数据结构来完成地址的转换,比如说分页,那就得要用页表。如果是一级页表,那你就得访问内存两次,第一次通过页表转换出块号,然后,块号加上页内偏移,就得到了内存中的物理地址,这个是一个计算过程,那么在CPU中就完成了啊,那也就是说CPU,根据地址,这样换算好一个逻辑地址,因为我们的页表是放在内存上的,如果是基本分页要访问内存多少次,如果是二级分页,那么要访问内存多少次,这些大家都要非常的清楚啊。
分段相对来说,就会比较少一点,一个逻辑地址之后,我们要知道它分成多少页,然后这里这地方像索引表,就是我们在磁盘上存文件的时候,物理结构里面,有个索引结构,跟这个页表,是一模一样的,给了你一个64位的逻辑地址,然后分完了之后,每一页是多大,或者每一块是多大,问你这个64位,要分成多少级一秒。一定要会算,必考。考试的时候会考到六级页表
最后讲一个虚拟存储器,它主要利用了两个局部性特征,一个叫做时间局部性,第二类叫空间局部性
虚拟存储器要具有请求调入和置换功能,那么这里面就讲到了一个缺页中断。通常讲的它都是CPU执行完一条指令之后,会去检查一下当前存储中断信号的硬件上面,有没有中断信号,如果有中断信号,并且这些中断信号的这个重要性高于当前的这个执行的这个代码,那么就会中断。一条指令执行完被中断的话,那么下一个时刻,再轮到这个进指令所有归属的进程的时候,是从被中断进指令的下一条指令开始执行,但是缺页不是这样的,缺页的指令是哪里中断,哪里开始要重新执行
虚拟存储器特征有 多次性,置换性,虚拟性
React 学习笔记
React本身并不严格属于MVC(模型-视图-控制器)、MVP(模型-视图-呈现器)或MVVM(模型-视图-视图模型)这三种软件架构模式中的任何一种。React更专注于构建用户界面的视图层,主要提供组件化开发的方式来构建复杂的用户界面。
井字棋
返回元素
React 组件必须返回单个 JSX 元素,不能像两个按钮那样返回多个相邻的 JSX 元素。要解决此问题,可以使用 Fragment(<> 与 </>)包裹多个相邻的 JSX 元素,如下所示:
export default function Square() { |
Props 传递
function Square({ value }) { |
事件处理
function Square({ value }) { |
保存状态
React 提供了一个名为 useState 的特殊函数,可以从组件中调用它来让它“记住”一些东西。让我们将 Square 的当前值存储在 state 中,并在单击 Square 时更改它。
在文件的顶部导入 useState。从 Square 组件中移除 value props。在调用 useState 的 Square 的开头添加一个新行。让它返回一个名为 value 的 state 变量:
import { useState } from 'react'; |
value 存储值,而 setValue 是可用于更改值的函数。
传递给 useState 的 null 用作这个 state 变量的初始值,因此此处 value 的值开始时等于 null。
function Square() { |
每个 Square 都有自己的 state:存储在每个 Square 中的 value 完全独立于其他的 Square。当你在组件中调用 set 函数时,React 也会自动更新内部的子组件。
状态提升
目前,每个 Square 组件都维护着游戏 state 的一部分。要检查井字棋游戏中的赢家,Board 需要以某种方式知道 9 个 Square 组件中每个组件的 state。
而如果向每个 Square“询问”Square 的 state,会比较复杂
最好的方法是将游戏的 state 存储在 Board 父组件中,而不是每个 Square 中。
Board 组件可以通过传递一个 props 来告诉每个 Square 显示什么,就像你将数字传递给每个 Square 时所做的那样。
要从多个子组件收集数据,或让两个子组件相互通信,请改为在其父组件中声明共享 state。父组件可以通过 props 将该 state 传回给子组件。这使子组件彼此同步并与其父组件保持同步。
重构 React 组件时,将状态提升到父组件中很常见。
export default function Board() { |
Array(9).fill(null) 创建了一个包含九个元素的数组,并将它们中的每一个都设置为 null。
现在Board 组件需要将 value props 向下传递给它渲染的每个 Square:
export default function Board() { |
现在从 Board 组件通过 props 向下传递一个函数到 Square 组件,让 Square在被单击时调用该函数。
function Square({ value, onSquareClick }) { |
这里将会报错 onSquareClick={handleClick(0)}
handleClick(0) 调用将成为渲染 Board 组件的一部分。因为 handleClick(0) 通过调用 setSquares 改变了棋盘组件的 state,所以你的整个棋盘组件将再次重新渲染。但这再次运行了 handleClick(0),导致无限循环:
之前未发生这个问题是因为:当你传递 onSquareClick={handleClick} 时,你将 handleClick 函数作为 props 向下传递。并不是在调用它!但是现在你立即调用了该函数——注意 handleClick(0) 中的括号——这就是它运行得太早的原因。你不想在用户点击之前调用 handleClick!
你可以通过创建调用
handleClick(0)的函数(如handleFirstSquareClick)、调用handleClick(1)的函数(如handleSecondSquareClick)等来修复。你可以将这些函数作为onSquareClick={handleFirstSquareClick}之类的 props 传递(而不是调用)。这将解决无限循环的问题。
但该方法过于冗余,可以直接利用箭头函数解决:onSquareClick={() => handleClick(0)}
现在回顾一下当用户单击你的棋盘左上角的方块以向其添加 X 时会发生什么:
- 单击左上角的方块运行
button从Square接收到的onClickprops 的函数。Square组件从Board通过onSquareClickprops 接收到该函数。Board组件直接在 JSX 中定义了该函数。它使用参数0调用handleClick。 handleClick使用参数(0)将squares数组的第一个元素从null更新为X。Board组件的squaresstate 已更新,因此Board及其所有子组件都将重新渲染。这会导致索引为0的Square组件的valueprops 从null更改为X。
实现交替落子
export default function Board() { |
实现状态回溯
把过去的 squares 数组存储在另一个名为 history 的数组中,把它存储为一个新的 state 变量。history 数组表示所有棋盘的 state,从第一步到最后一步
你现在将编写一个名为 Game 的新顶级组件来显示过去的着法列表。这就是放置包含整个游戏历史的 history state 的地方。
将 history state 放入 Game 组件将使你可以从其 Board 子组件中删除 squares state。就像你将 state 从 Square 组件“提升”到 Board 组件一样,你现在将把它从 Board 提升到顶层 Game 组件。这使 Game 组件可以完全控制 Board 的数据,并使它让 Board 渲染来自 history 的之前的回合。
不变性
请注意在 handleClick 中,你调用了 .slice() 来创建 squares 数组的副本而不是修改现有数组。为了解释原因,我们需要讨论不变性以及为什么学习不变性很重要。
通常有两种更改数据的方法。第一种方法是通过直接更改数据的值来改变数据。第二种方法是使用具有所需变化的新副本替换数据。如果你改变 squares 数组,它会是这样的:
const squares = [null, null, null, null, null, null, null, null, null]; |
如果你在不改变 squares 数组的情况下更改数据,它会是这样的:
const squares = [null, null, null, null, null, null, null, null, null]; |
结果是一样的,但通过不直接改变(改变底层数据),你可以获得几个好处。
不变性使复杂的功能更容易实现。在本教程的后面,你将实现一个“时间旅行”功能,让你回顾游戏的历史并“跳回”到过去的动作。此功能并非特定于游戏——撤消和重做某些操作的能力是应用程序的常见要求。避免数据直接突变可以让你保持以前版本的数据完好无损,并在以后重用它们。
不变性还有另一个好处。默认情况下,当父组件的 state 发生变化时,所有子组件都会自动重新渲染。这甚至包括未受变化影响的子组件。尽管重新渲染本身不会引起用户注意(你不应该主动尝试避免它!),但出于性能原因,你可能希望跳过重新渲染显然不受其影响的树的一部分。不变性使得组件比较其数据是否已更改的成本非常低。
评论


